这是Andrej Karpathy 零基础学习神经网络的视频课的第二节课,在这一节课中,我们会实现一个简单的英文名生成网络。
准备工作
安装Python
安装Pytorch
观看视频课程
正式开始编写代码
准备姓名集
首先,我们需要准备好姓名文本,这可以从GitHub上直接下载,读者可以点击直接下载进行下载。笔者已经把链接设置好了。
我们先来写一个main.py,看看我们的姓名集:
words = open('names.txt','r').read().splitlines()
print(words[:10])
print(len(words))
print(min(len(word) for word in words))
print(max(len(word) for word in words))
运行一下:
D:\Data\Anacondea\envs\lora\python.exe D:\Data\Python\Class_2\main.py
['emma', 'olivia', 'ava', 'isabella', 'sophia', 'charlotte', 'mia', 'amelia', 'harper', 'evelyn']
32033
2
15
可以看到总共有32033个姓名集,说明我们的姓名集加载已经成功了。
准备样本集
由于我们这个模型纯粹的只是依据上一个字母去猜下一个字母,因此,我们需要统计整个姓名集中,每一个上一个字母与下一个字母的组合出现了多少次。其次数越多,说明这样的概率越大,其次数越少,说明这样的概率越低。首先我们需要把这个姓名集中的每一个姓名的前面和后面各插入一个起始符和终止符,这样模型才能知道在这个字母之后,有多大的概率直接终止,结束这个名字的生成:
words = open('names.txt','r').read().splitlines()
b = {}
for word in words:
    chs = ['<S>'] + list(word) + ['<E>']
    for i in range(len(chs) -1):
        bigram = (chs[i], chs[i+1])
        if bigram in b:
            b[bigram] += 1
        else:
            b[bigram] = 1

print(sorted(b.items(), key=lambda kv: kv[-1], reverse = True))
运行一下:
D:\Data\Anacondea\envs\lora\python.exe D:\Data\Python\Class_2\main.py
[(('n', '<E>'), 6763), (('a', '<E>'), 6640), (('a', 'n'), 5438), (('<S>', 'a'), 4410), (('e', '<E>'), 3983), (('a', 'r'), 3264), (('e', 'l'), 3248), (('r', 'i'), 3033), (('n', 'a'), 2977), (('<S>', 'k'), 2963), (('l', 'e'), 2921), (('e', 'n'), 2675), (('l', 'a'), 2623), (('m', 'a'), 2590), (('<S>', 'm'), 2538), (('a', 'l'), 2528), (('i', '<E>'), 2489), (('l', 'i'), 2480), (('i', 'a'), 2445), (('<S>', 'j'), 2422), (('o', 'n'), 2411), (('h', '<E>'), 2409), (('r', 'a'), 2356), (('a', 'h'), 2332), (('h', 'a'), 2244), (('y', 'a'), 2143), (('i', 'n'), 2126), (('<S>', 's'), 2055), (('a', 'y'), 2050), (('y', '<E>'), 2007), (('e', 'r'), 1958), (('n', 'n'), 1906), (('y', 'n'), 1826), (('k', 'a'), 1731), (('n', 'i'), 1725), (('r', 'e'), 1697), (('<S>', 'd'), 1690), (('i', 'e'), 1653), (('a', 'i'), 1650), (('<S>', 'r'), 1639), (('a', 'm'), 1634), (('l', 'y'), 1588), (('<S>', 'l'), 1572), (('<S>', 'c'), 1542), (('<S>', 'e'), 1531), (('j', 'a'), 1473), (('r', '<E>'), 1377), (('n', 'e'), 1359), (('l', 'l'), 1345), (('i', 'l'), 1345), (('i', 's'), 1316), (('l', '<E>'), 1314), (('<S>', 't'), 1308), (('<S>', 'b'), 1306), (('d', 'a'), 1303), (('s', 'h'), 1285), (('d', 'e'), 1283), (('e', 'e'), 1271), (('m', 'i'), 1256), (('s', 'a'), 1201), (('s', '<E>'), 1169), (('<S>', 'n'), 1146), (('a', 's'), 1118), (('y', 'l'), 1104), (('e', 'y'), 1070), (('o', 'r'), 1059), (('a', 'd'), 1042), (('t', 'a'), 1027), (('<S>', 'z'), 929), (('v', 'i'), 911), (('k', 'e'), 895), (('s', 'e'), 884), (('<S>', 'h'), 874), (('r', 'o'), 869), (('e', 's'), 861), (('z', 'a'), 860), (('o', '<E>'), 855), (('i', 'r'), 849), (('b', 'r'), 842), (('a', 'v'), 834), (('m', 'e'), 818), (('e', 'i'), 818), (('c', 'a'), 815), (('i', 'y'), 779), (('r', 'y'), 773), (('e', 'm'), 769), (('s', 't'), 765), (('h', 'i'), 729), (('t', 'e'), 716), (('n', 'd'), 704), (('l', 'o'), 692), (('a', 'e'), 692), (('a', 't'), 687), (('s', 'i'), 684), (('e', 'a'), 679), (('d', 'i'), 674), (('h', 'e'), 674), (('<S>', 'g'), 669), (('t', 'o'), 667), (('c', 'h'), 664), (('b', 'e'), 655), (('t', 'h'), 647), (('v', 'a'), 642), (('o', 'l'), 619), (('<S>', 'i'), 591), (('i', 'o'), 588), (('e', 't'), 580), (('v', 'e'), 568), (('a', 'k'), 568), (('a', 'a'), 556), (('c', 'e'), 551), (('a', 'b'), 541), (('i', 't'), 541), (('<S>', 'y'), 535), (('t', 'i'), 532), (('s', 'o'), 531), (('m', '<E>'), 516), (('d', '<E>'), 516), (('<S>', 'p'), 515), (('i', 'c'), 509), (('k', 'i'), 509), (('o', 's'), 504), (('n', 'o'), 496), (('t', '<E>'), 483), (('j', 'o'), 479), (('u', 's'), 474), (('a', 'c'), 470), (('n', 'y'), 465), (('e', 'v'), 463), (('s', 's'), 461), (('m', 'o'), 452), (('i', 'k'), 445), (('n', 't'), 443), (('i', 'd'), 440), (('j', 'e'), 440), (('a', 'z'), 435), (('i', 'g'), 428), (('i', 'm'), 427), (('r', 'r'), 425), (('d', 'r'), 424), (('<S>', 'f'), 417), (('u', 'r'), 414), (('r', 'l'), 413), (('y', 's'), 401), (('<S>', 'o'), 394), (('e', 'd'), 384), (('a', 'u'), 381), (('c', 'o'), 380), (('k', 'y'), 379), (('d', 'o'), 378), (('<S>', 'v'), 376), (('t', 't'), 374), (('z', 'e'), 373), (('z', 'i'), 364), (('k', '<E>'), 363), (('g', 'h'), 360), (('t', 'r'), 352), (('k', 'o'), 344), (('t', 'y'), 341), (('g', 'e'), 334), (('g', 'a'), 330), (('l', 'u'), 324), (('b', 'a'), 321), (('d', 'y'), 317), (('c', 'k'), 316), (('<S>', 'w'), 307), (('k', 'h'), 307), (('u', 'l'), 301), (('y', 'e'), 301), (('y', 'r'), 291), (('m', 'y'), 287), (('h', 'o'), 287), (('w', 'a'), 280), (('s', 'l'), 279), (('n', 's'), 278), (('i', 'z'), 277), (('u', 'n'), 275), (('o', 'u'), 275), (('n', 'g'), 273), (('y', 'd'), 272), (('c', 'i'), 271), (('y', 'o'), 271), (('i', 'v'), 269), (('e', 'o'), 269), (('o', 'm'), 261), (('r', 'u'), 252), (('f', 'a'), 242), (('b', 'i'), 217), (('s', 'y'), 215), (('n', 'c'), 213), (('h', 'y'), 213), (('p', 'a'), 209), (('r', 't'), 208), (('q', 'u'), 206), (('p', 'h'), 204), (('h', 'r'), 204), (('j', 'u'), 202), (('g', 'r'), 201), (('p', 'e'), 197), (('n', 'l'), 195), (('y', 'i'), 192), (('g', 'i'), 190), (('o', 'd'), 190), (('r', 's'), 190), (('r', 'd'), 187), (('h', 'l'), 185), (('s', 'u'), 185), (('a', 'x'), 182), (('e', 'z'), 181), (('e', 'k'), 178), (('o', 'v'), 176), (('a', 'j'), 175), (('o', 'h'), 171), (('u', 'e'), 169), (('m', 'm'), 168), (('a', 'g'), 168), (('h', 'u'), 166), (('x', '<E>'), 164), (('u', 'a'), 163), (('r', 'm'), 162), (('a', 'w'), 161), (('f', 'i'), 160), (('z', '<E>'), 160), (('u', '<E>'), 155), (('u', 'm'), 154), (('e', 'c'), 153), (('v', 'o'), 153), (('e', 'h'), 152), (('p', 'r'), 151), (('d', 'd'), 149), (('o', 'a'), 149), (('w', 'e'), 149), (('w', 'i'), 148), (('y', 'm'), 148), (('z', 'y'), 147), (('n', 'z'), 145), (('y', 'u'), 141), (('r', 'n'), 140), (('o', 'b'), 140), (('k', 'l'), 139), (('m', 'u'), 139), (('l', 'd'), 138), (('h', 'n'), 138), (('u', 'd'), 136), (('<S>', 'x'), 134), (('t', 'l'), 134), (('a', 'f'), 134), (('o', 'e'), 132), (('e', 'x'), 132), (('e', 'g'), 125), (('f', 'e'), 123), (('z', 'l'), 123), (('u', 'i'), 121), (('v', 'y'), 121), (('e', 'b'), 121), (('r', 'h'), 121), (('j', 'i'), 119), (('o', 't'), 118), (('d', 'h'), 118), (('h', 'm'), 117), (('c', 'l'), 116), (('o', 'o'), 115), (('y', 'c'), 115), (('o', 'w'), 114), (('o', 'c'), 114), (('f', 'r'), 114), (('b', '<E>'), 114), (('m', 'b'), 112), (('z', 'o'), 110), (('i', 'b'), 110), (('i', 'u'), 109), (('k', 'r'), 109), (('g', '<E>'), 108), (('y', 'v'), 106), (('t', 'z'), 105), (('b', 'o'), 105), (('c', 'y'), 104), (('y', 't'), 104), (('u', 'b'), 103), (('u', 'c'), 103), (('x', 'a'), 103), (('b', 'l'), 103), (('o', 'y'), 103), (('x', 'i'), 102), (('i', 'f'), 101), (('r', 'c'), 99), (('c', '<E>'), 97), (('m', 'r'), 97), (('n', 'u'), 96), (('o', 'p'), 95), (('i', 'h'), 95), (('k', 's'), 95), (('l', 's'), 94), (('u', 'k'), 93), (('<S>', 'q'), 92), (('d', 'u'), 92), (('s', 'm'), 90), (('r', 'k'), 90), (('i', 'x'), 89), (('v', '<E>'), 88), (('y', 'k'), 86), (('u', 'w'), 86), (('g', 'u'), 85), (('b', 'y'), 83), (('e', 'p'), 83), (('g', 'o'), 83), (('s', 'k'), 82), (('u', 't'), 82), (('a', 'p'), 82), (('e', 'f'), 82), (('i', 'i'), 82), (('r', 'v'), 80), (('f', '<E>'), 80), (('t', 'u'), 78), (('y', 'z'), 78), (('<S>', 'u'), 78), (('l', 't'), 77), (('r', 'g'), 76), (('c', 'r'), 76), (('i', 'j'), 76), (('w', 'y'), 73), (('z', 'u'), 73), (('l', 'v'), 72), (('h', 't'), 71), (('j', '<E>'), 71), (('x', 't'), 70), (('o', 'i'), 69), (('e', 'u'), 69), (('o', 'k'), 68), (('b', 'd'), 65), (('a', 'o'), 63), (('p', 'i'), 61), (('s', 'c'), 60), (('d', 'l'), 60), (('l', 'm'), 60), (('a', 'q'), 60), (('f', 'o'), 60), (('p', 'o'), 59), (('n', 'k'), 58), (('w', 'n'), 58), (('u', 'h'), 58), (('e', 'j'), 55), (('n', 'v'), 55), (('s', 'r'), 55), (('o', 'z'), 54), (('i', 'p'), 53), (('l', 'b'), 52), (('i', 'q'), 52), (('w', '<E>'), 51), (('m', 'c'), 51), (('s', 'p'), 51), (('e', 'w'), 50), (('k', 'u'), 50), (('v', 'r'), 48), (('u', 'g'), 47), (('o', 'x'), 45), (('u', 'z'), 45), (('z', 'z'), 45), (('j', 'h'), 45), (('b', 'u'), 45), (('o', 'g'), 44), (('n', 'r'), 44), (('f', 'f'), 44), (('n', 'j'), 44), (('z', 'h'), 43), (('c', 'c'), 42), (('r', 'b'), 41), (('x', 'o'), 41), (('b', 'h'), 41), (('p', 'p'), 39), (('x', 'l'), 39), (('h', 'v'), 39), (('b', 'b'), 38), (('m', 'p'), 38), (('x', 'x'), 38), (('u', 'v'), 37), (('x', 'e'), 36), (('w', 'o'), 36), (('c', 't'), 35), (('z', 'm'), 35), (('t', 's'), 35), (('m', 's'), 35), (('c', 'u'), 35), (('o', 'f'), 34), (('u', 'x'), 34), (('k', 'w'), 34), (('p', '<E>'), 33), (('g', 'l'), 32), (('z', 'r'), 32), (('d', 'n'), 31), (('g', 't'), 31), (('g', 'y'), 31), (('h', 's'), 31), (('x', 's'), 31), (('g', 's'), 30), (('x', 'y'), 30), (('y', 'g'), 30), (('d', 'm'), 30), (('d', 's'), 29), (('h', 'k'), 29), (('y', 'x'), 28), (('q', '<E>'), 28), (('g', 'n'), 27), (('y', 'b'), 27), (('g', 'w'), 26), (('n', 'h'), 26), (('k', 'n'), 26), (('g', 'g'), 25), (('d', 'g'), 25), (('l', 'c'), 25), (('r', 'j'), 25), (('w', 'u'), 25), (('l', 'k'), 24), (('m', 'd'), 24), (('s', 'w'), 24), (('s', 'n'), 24), (('h', 'd'), 24), (('w', 'h'), 23), (('y', 'j'), 23), (('y', 'y'), 23), (('r', 'z'), 23), (('d', 'w'), 23), (('w', 'r'), 22), (('t', 'n'), 22), (('l', 'f'), 22), (('y', 'h'), 22), (('r', 'w'), 21), (('s', 'b'), 21), (('m', 'n'), 20), (('f', 'l'), 20), (('w', 's'), 20), (('k', 'k'), 20), (('h', 'z'), 20), (('g', 'd'), 19), (('l', 'h'), 19), (('n', 'm'), 19), (('x', 'z'), 19), (('u', 'f'), 19), (('f', 't'), 18), (('l', 'r'), 18), (('p', 't'), 17), (('t', 'c'), 17), (('k', 't'), 17), (('d', 'v'), 17), (('u', 'p'), 16), (('p', 'l'), 16), (('l', 'w'), 16), (('p', 's'), 16), (('o', 'j'), 16), (('r', 'q'), 16), (('y', 'p'), 15), (('l', 'p'), 15), (('t', 'v'), 15), (('r', 'p'), 14), (('l', 'n'), 14), (('e', 'q'), 14), (('f', 'y'), 14), (('s', 'v'), 14), (('u', 'j'), 14), (('v', 'l'), 14), (('q', 'a'), 13), (('u', 'y'), 13), (('q', 'i'), 13), (('w', 'l'), 13), (('p', 'y'), 12), (('y', 'f'), 12), (('c', 'q'), 11), (('j', 'r'), 11), (('n', 'w'), 11), (('n', 'f'), 11), (('t', 'w'), 11), (('m', 'z'), 11), (('u', 'o'), 10), (('f', 'u'), 10), (('l', 'z'), 10), (('h', 'w'), 10), (('u', 'q'), 10), (('j', 'y'), 10), (('s', 'z'), 10), (('s', 'd'), 9), (('j', 'l'), 9), (('d', 'j'), 9), (('k', 'm'), 9), (('r', 'f'), 9), (('h', 'j'), 9), (('v', 'n'), 8), (('n', 'b'), 8), (('i', 'w'), 8), (('h', 'b'), 8), (('b', 's'), 8), (('w', 't'), 8), (('w', 'd'), 8), (('v', 'v'), 7), (('v', 'u'), 7), (('j', 's'), 7), (('m', 'j'), 7), (('f', 's'), 6), (('l', 'g'), 6), (('l', 'j'), 6), (('j', 'w'), 6), (('n', 'x'), 6), (('y', 'q'), 6), (('w', 'k'), 6), (('g', 'm'), 6), (('x', 'u'), 5), (('m', 'h'), 5), (('m', 'l'), 5), (('j', 'm'), 5), (('c', 's'), 5), (('j', 'v'), 5), (('n', 'p'), 5), (('d', 'f'), 5), (('x', 'd'), 5), (('z', 'b'), 4), (('f', 'n'), 4), (('x', 'c'), 4), (('m', 't'), 4), (('t', 'm'), 4), (('z', 'n'), 4), (('z', 't'), 4), (('p', 'u'), 4), (('c', 'z'), 4), (('b', 'n'), 4), (('z', 's'), 4), (('f', 'w'), 4), (('d', 't'), 4), (('j', 'd'), 4), (('j', 'c'), 4), (('y', 'w'), 4), (('v', 'k'), 3), (('x', 'w'), 3), (('t', 'j'), 3), (('c', 'j'), 3), (('q', 'w'), 3), (('g', 'b'), 3), (('o', 'q'), 3), (('r', 'x'), 3), (('d', 'c'), 3), (('g', 'j'), 3), (('x', 'f'), 3), (('z', 'w'), 3), (('d', 'k'), 3), (('u', 'u'), 3), (('m', 'v'), 3), (('c', 'x'), 3), (('l', 'q'), 3), (('p', 'b'), 2), (('t', 'g'), 2), (('q', 's'), 2), (('t', 'x'), 2), (('f', 'k'), 2), (('b', 't'), 2), (('j', 'n'), 2), (('k', 'c'), 2), (('z', 'k'), 2), (('s', 'j'), 2), (('s', 'f'), 2), (('z', 'j'), 2), (('n', 'q'), 2), (('f', 'z'), 2), (('h', 'g'), 2), (('w', 'w'), 2), (('k', 'j'), 2), (('j', 'k'), 2), (('w', 'm'), 2), (('z', 'c'), 2), (('z', 'v'), 2), (('w', 'f'), 2), (('q', 'm'), 2), (('k', 'z'), 2), (('j', 'j'), 2), (('z', 'p'), 2), (('j', 't'), 2), (('k', 'b'), 2), (('m', 'w'), 2), (('h', 'f'), 2), (('c', 'g'), 2), (('t', 'f'), 2), (('h', 'c'), 2), (('q', 'o'), 2), (('k', 'd'), 2), (('k', 'v'), 2), (('s', 'g'), 2), (('z', 'd'), 2), (('q', 'r'), 1), (('d', 'z'), 1), (('p', 'j'), 1), (('q', 'l'), 1), (('p', 'f'), 1), (('q', 'e'), 1), (('b', 'c'), 1), (('c', 'd'), 1), (('m', 'f'), 1), (('p', 'n'), 1), (('w', 'b'), 1), (('p', 'c'), 1), (('h', 'p'), 1), (('f', 'h'), 1), (('b', 'j'), 1), (('f', 'g'), 1), (('z', 'g'), 1), (('c', 'p'), 1), (('p', 'k'), 1), (('p', 'm'), 1), (('x', 'n'), 1), (('s', 'q'), 1), (('k', 'f'), 1), (('m', 'k'), 1), (('x', 'h'), 1), (('g', 'f'), 1), (('v', 'b'), 1), (('j', 'p'), 1), (('g', 'z'), 1), (('v', 'd'), 1), (('d', 'b'), 1), (('v', 'h'), 1), (('h', 'h'), 1), (('g', 'v'), 1), (('d', 'q'), 1), (('x', 'b'), 1), (('w', 'z'), 1), (('h', 'q'), 1), (('j', 'b'), 1), (('x', 'm'), 1), (('w', 'g'), 1), (('t', 'b'), 1), (('z', 'x'), 1)]
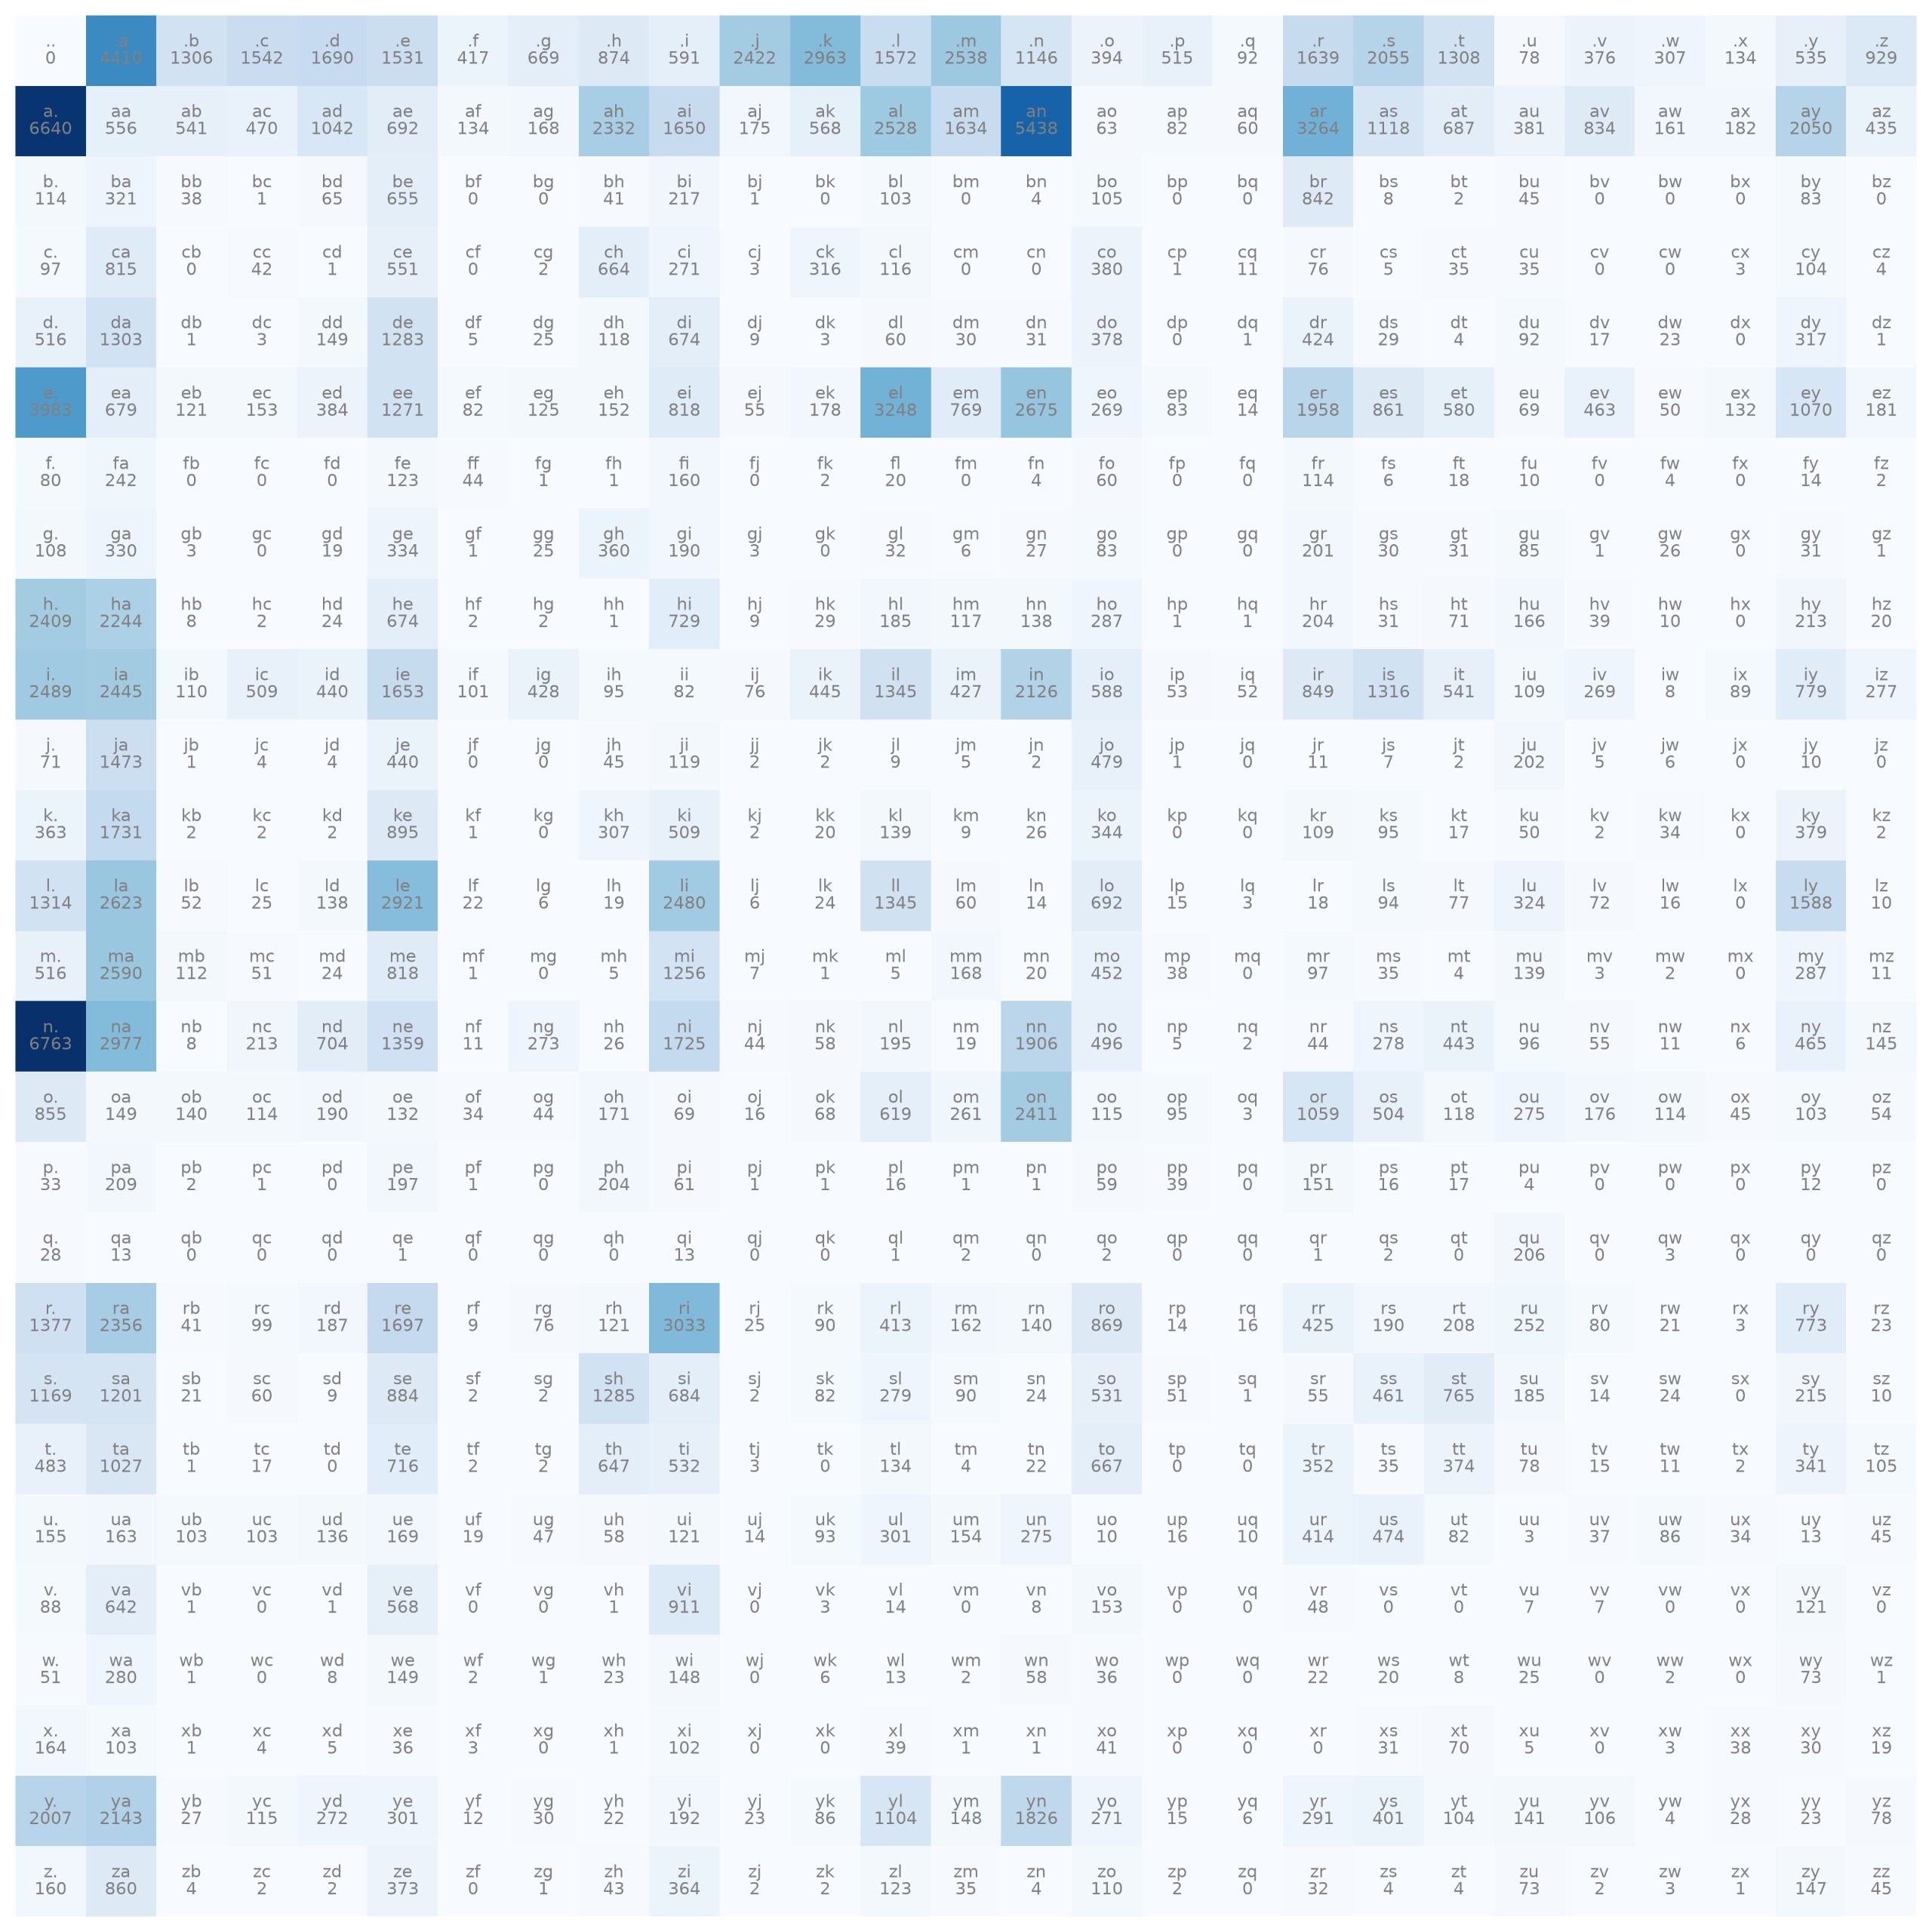
可以看到,我们已经对整个姓名集做了一次完全的统计,每一种组合都有其计数(如果为0则没有计数)。我们肉眼上也可以观察到一些规律,比如名字中n结尾和a结尾比较多,这事实上就是我们今天所需要使用到的样本集了,模型纯粹的就是学习前一个字符产生后一个字符的概率关系,并且以此来生成姓名。
我们今天想使用Pytorch,先生成一个27×27的矩阵。因为起始符和终止符我们实际上可以用一个字符来代替,所以一共这个模型需要学习的关系个数就是26个字母加上一个起始和或终止符组成的,所以一共是27个字符。我们先打开一个27×27的矩阵,并且把这27个字符做成一个与其下标对应的字典:
words = open('names.txt','r').read().splitlines()
import torch
# 建立一个27×27的网格
N = torch.zeros((27, 27), dtype = torch.int32)

# 将姓名中出现的所有字母做成一个列表     chars = ['a','b','c','d','e' ...]
chars = sorted(list(set(''.join(words))))
# 我们希望把第0个位置让给开启或结束占位符'.'       stoi = {'a': 1, 'b': 2, 'c': 3, 'd': 4, 'e': 5 ...}
stoi = {s:i+1 for i, s in enumerate(chars)}
stoi['.'] = 0
# 建立反向索引        itos = {0: '.', 1: 'a', 2: 'b', 3: 'c', ...}
itos = {i: s for s, i in stoi.items()}
print(stoi)
print(itos)
我们运行一下看看:
D:\Data\Anacondea\envs\lora\python.exe D:\Data\Python\Class_2\main.py
{'a': 1, 'b': 2, 'c': 3, 'd': 4, 'e': 5, 'f': 6, 'g': 7, 'h': 8, 'i': 9, 'j': 10, 'k': 11, 'l': 12, 'm': 13, 'n': 14, 'o': 15, 'p': 16, 'q': 17, 'r': 18, 's': 19, 't': 20, 'u': 21, 'v': 22, 'w': 23, 'x': 24, 'y': 25, 'z': 26, '.': 0}
{1: 'a', 2: 'b', 3: 'c', 4: 'd', 5: 'e', 6: 'f', 7: 'g', 8: 'h', 9: 'i', 10: 'j', 11: 'k', 12: 'l', 13: 'm', 14: 'n', 15: 'o', 16: 'p', 17: 'q', 18: 'r', 19: 's', 20: 't', 21: 'u', 22: 'v', 23: 'w', 24: 'x', 25: 'y', 26: 'z', 0: '.'}

进程已结束,退出代码为 0
可以看到,stoi和itos字典和和我们预期的数据结构一样。我们现在修改代码,重新生成b字典,这一次我们将起始符和终止符都用“.”来代替,并且把B字典的数据放在N矩阵中:
words = open('names.txt','r').read().splitlines()
import torch
# 建立一个27×27的网格
N = torch.zeros((27, 27), dtype = torch.int32)

# 将姓名中出现的所有字母做成一个列表     chars = ['a','b','c','d','e' ...]
chars = sorted(list(set(''.join(words))))
# 我们希望把第0个位置让给开启或结束占位符'.'       stoi = {'a': 1, 'b': 2, 'c': 3, 'd': 4, 'e': 5 ...}
stoi = {s:i+1 for i, s in enumerate(chars)}
stoi['.'] = 0
# 建立反向索引        itos = {0: '.', 1: 'a', 2: 'b', 3: 'c', ...}
itos = {i: s for s, i in stoi.items()}

b = {}
for word in words:
    chs = ['.'] + list(word) + ['.']
    for i in range(len(chs) -1):
        bigram = (chs[i], chs[i+1])
        if bigram in b:
            b[bigram] += 1
        else:
            b[bigram] = 1

for (ch1, ch2), count in b.items():
    ix1 = stoi[ch1]
    ix2 = stoi[ch2]
    N[ix1, ix2] = count
为了能够可视化显示,我们通过matplotlib来生成一个图片:
import matplotlib.pyplot as plt

plt.figure(figsize=(80.0, 80.0))
plt.imshow(N, cmap='Blues')
for i in range(27):
    for j in range(27):
        chstr = itos[i] + itos[j]
        plt.text(j, i, chstr, ha="center", va="bottom", color='gray', fontsize=6)
        plt.text(j, i, N[i, j].item(), ha="center", va="top", color='gray', fontsize=6)
plt.axis('off')
plt.savefig('bigram_heatmap.png', dpi=150, bbox_inches='tight')
plt.show()
我们来运行一下,看看效果:
根据统计出来的概率生成随机英文名
那现在N[0]就是这一个阵列中每一行的数字。由于我们最终是根据上一个字符,通过概率统计的方式随机出下一个字符,那我们需要将其进行归一化:
p = N[0].float()
p = p / torch.sum(p)
print(p)
执行一下,看一下输出:
tensor([0.0000, 0.1377, 0.0408, 0.0481, 0.0528, 0.0478, 0.0130, 0.0209, 0.0273,
        0.0184, 0.0756, 0.0925, 0.0491, 0.0792, 0.0358, 0.0123, 0.0161, 0.0029,
        0.0512, 0.0642, 0.0408, 0.0024, 0.0117, 0.0096, 0.0042, 0.0167, 0.0290])
可以看到现在这些数字就是用来表示概率了,而不是像之前那样表示其出现的次数。现在我们尝试一下对第0行根据概率输出一个字符,其意义也就是根据概率输出这个名字的第一个字母:
g = torch.Generator().manual_seed(2147483647)
ix = torch.multinomial(p, num_samples=1, replacement = True, generator=g).item()
print(itos[ix])我们通过torch.Generator().manual_seed(2147483647)固定了随机种子,这样我们未来的每一次运行都会有相同的输出。multinomial().item()方法最后会拿到一个数字。也就是p中的某一个下标,我们执行一下,看看这一次随机出了哪一个字母:
c随机出了C,也就是其出现的概率是4%,也算是抽到奖了,这概率也比较低呀。
Pytorch提供了torch.rand()方法,能够在0和1之中随机生成指定数量的数字,如果我们生成多个数字,再进行归一化,就可以获得一个随机的概率列表。我们来看一下:
g = torch.Generator().manual_seed(2147483647)
p = torch.rand(3, generator=g)
p = p / p.sum()
print(p)
看一下输出:
tensor([0.6064, 0.3033, 0.0903])我们再来看一下,不同的方法对张量维度的变化:
print(N.shape)
print(N.sum(1, keepdim=True).shape)
print(N.sum(1).shape)
运行一下:
torch.Size([27, 27])
torch.Size([27, 1])
torch.Size([27])
可以看到,原本是 27 行乘 27 列的向量,在进行一次求和之后,如果我们没有指定keepdim=True,那么PyTorch会将其合并成一个长度为 27 的一维数组,而如果我们指定keepdim=True,那么它就会将其合并成一个 27 行 1 列的列向量。
由于在我们的样本中,可能会出现某一种组合的数量为 0 的情况,这会导致该情况永远不可能被随机。因此,我们可以进行平滑处理:将每一种可能性加 1 之后再进行归一化。这样就可以确保每一种组合至少都有概率出现,而不是断崖式地为零:
print(N[0])
P = (N+1).float()
P /= P.sum(1, keepdim=True)
print(P[0])
运行一下:
tensor([   0, 4410, 1306, 1542, 1690, 1531,  417,  669,  874,  591, 2422, 2963,
        1572, 2538, 1146,  394,  515,   92, 1639, 2055, 1308,   78,  376,  307,
         134,  535,  929], dtype=torch.int32)
tensor([3.1192e-05, 1.3759e-01, 4.0767e-02, 4.8129e-02, 5.2745e-02, 4.7785e-02,
        1.3038e-02, 2.0898e-02, 2.7293e-02, 1.8465e-02, 7.5577e-02, 9.2452e-02,
        4.9064e-02, 7.9195e-02, 3.5777e-02, 1.2321e-02, 1.6095e-02, 2.9008e-03,
        5.1154e-02, 6.4130e-02, 4.0830e-02, 2.4641e-03, 1.1759e-02, 9.6070e-03,
        4.2109e-03, 1.6719e-02, 2.9008e-02])
可以看到,原本完全没有的情况也有概率出现了,只是概率很低罢了,这就是一种平滑处理。
现在我们实际上已经可以根据这个 27×27 的矩阵,完全通过概率的方式生成名字了,我们来测试一下:
g = torch.Generator().manual_seed(2147483647)
for i in range(5):
    out = []
    ix = 0
    while True:
        p = P[ix]
        ix = torch.multinomial(p, num_samples=1, replacement = True, generator=g).item()
        out.append(itos[ix])
        if ix == 0:
            break
    print("".join(out))
我们运行一下,输出5个名字:
cexze.
momasurailezitynn.
konimittain.
llayn.
ka.
好吧,这些看起来不那么像名字,但是至少从原理上我们实现了。
计算损失值
现在我们再想一个办法来计算它的损失率。其实基本原理很简单:对于一个样本(既可以是样本集中已有的样本,也可以是我们刚刚通过概率方式生成的新的名字作为样本),都会有若干个字母对,每一个字母对会有一个出现的概率。我们只需要将这个概率相乘,就是一个合理的损失值了。但是由于本身每一个字母对出现的概率都很低,如果我们一直这样乘下去的话,这个数字会很快地趋近于0。因此,我们要借用对数的运算规则:log(a*b*c) = log(a) + log(b) + log(c)。我们先算出字母对出现概率的对数值,然后再进行相加,这样就会得到一个很大的负数值(loge(1)为0),最后我们再除以样本数量,就可以算出当前样本集的损失值。
未来我们训练出神经网络模型之后,理论上其损失值越逼近这个值越好,但是模型的损失值不可能低于这个损失值,因为样本集的损失值就是理论最低损失值了。我们先来实现这个计算损失值的方法:
log_likelihood = 0.0
n = 0

for word in words:
    chs = ['.'] + list(word) + ['.']
    for ch1, ch2 in zip(chs, chs[1:]):
       ix1 = stoi[ch1]
       ix2 = stoi[ch2]
       prob = P[ix1, ix2]
       logprob = torch.log(prob)
       log_likelihood += logprob
       n += 1

print(f"{log_likelihood=}")
nll = -log_likelihood
print(f"{nll=}")
print(f"{nll/n}")
运行一下:
log_likelihood=tensor(-559951.5625)
nll=tensor(559951.5625)
2.4543561935424805
可以看到,其本来加起来的对数值是-559951.5625,当我们除去样本数量之后,得到了平均损失值是2.45左右,接下来,我们要尽可能地让我们的模型接近样本级的平均损失值。
样本集向量化
我们现在需要准备用于给神经网络训练的样本,这个样本集它不能再像之前的方式直接输入字母,因为神经网络没有办法直接接收字母,在这次实验中,一共只有26个字母,加上一个由句号代表的起始和终止符,那么一共是27种可能性。我们通过上一个字符推断下一个字符,字符只有27种可能。那我们先可以将第一个字符映射为其数字,再将其转化为一个27维的向量,除了它所在的那个位置的值为1,其余的位置都为这一个字符。同理,每一个字符都可以通过这个27位的向量来表示,我们将main.py清空,通过代码来实现:
words = open('names.txt','r').read().splitlines()
import torch
# 建立一个27×27的网格
N = torch.zeros((27, 27), dtype = torch.int32)

# 将姓名中出现的所有字母做成一个列表     chars = ['a','b','c','d','e' ...]
chars = sorted(list(set(''.join(words))))
# 我们希望把第0个位置让给开启或结束占位符'.'       stoi = {'a': 1, 'b': 2, 'c': 3, 'd': 4, 'e': 5 ...}
stoi = {s:i+1 for i, s in enumerate(chars)}
stoi['.'] = 0
# 建立反向索引        itos = {0: '.', 1: 'a', 2: 'b', 3: 'c', ...}
itos = {i: s for s, i in stoi.items()}

xs, ys = [], []
for word in words[:1]:
    chs = ['.'] + list(word) + ['.']
    for ch1, ch2 in zip(chs, chs[1:]):
        ix1 = stoi[ch1]
        ix2 = stoi[ch2]
        # print(ch1, ch2, ix1, ix2)
        xs.append(ix1)
        ys.append(ix2)

xs = torch.tensor(xs)
ys = torch.tensor(ys)

print(xs, ys)

import torch.nn.functional as F
xenc = F.one_hot(xs, num_classes=27).float()
print(xenc)

print(xenc.dtype)
运行一下:
tensor([ 0,  5, 13, 13,  1]) tensor([ 5, 13, 13,  1,  0])
tensor([[1., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0.,
         0., 0., 0., 0., 0., 0., 0., 0., 0.],
        [0., 0., 0., 0., 0., 1., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0.,
         0., 0., 0., 0., 0., 0., 0., 0., 0.],
        [0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 1., 0., 0., 0., 0.,
         0., 0., 0., 0., 0., 0., 0., 0., 0.],
        [0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 1., 0., 0., 0., 0.,
         0., 0., 0., 0., 0., 0., 0., 0., 0.],
        [0., 1., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0.,
         0., 0., 0., 0., 0., 0., 0., 0., 0.]])
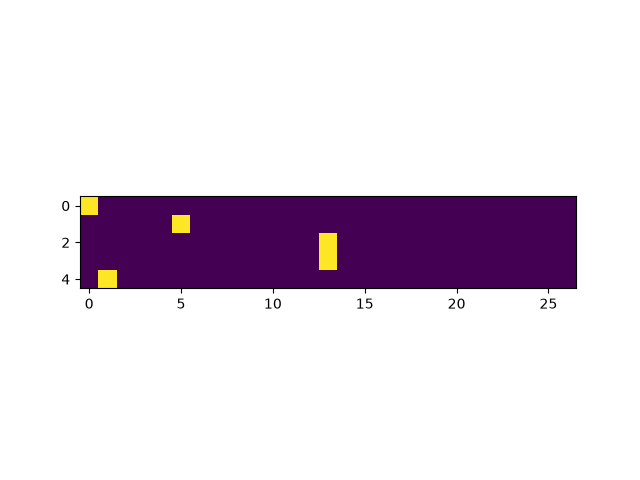
torch.float32可以看到,这里我们取了样本集中的最后一个名字作为测试。F.one_hot()方法就是我们用于将一个数字打为一个向量的方法。我们可以使用matplotlib来可视化:
import matplotlib.pyplot as plt
plt.imshow(xenc)
plt.show()
matplotlib可以可视化我们的xenc,运行一下:
对模型计算损失值
我们刚刚其实实现了一个计算损失值的方法,并且通过那个方法计算了整个样品集的损失值,但是我们现在希望计算当前模型的损失值,如何去实现呢?
import torch.nn.functional as F
g = torch.Generator().manual_seed(2147483647)
W = torch.randn((27, 27), generator=g)
我们先定义一个27×27的参数矩阵,然后用xenc @ W得到每一个输入的第一个字符之后,输出27个字符的各自的“倾向度”,然后对其取自然对数,再归一化,得到probs,这个probs是一个列表,记录了每一个输入字符后,输出27个字符的各自的概率,让我们来实现代码:
xenc = F.one_hot(xs, num_classes=27).float()

logits = xenc @ W
print(logits)
# 取自然指数
counts = logits.exp()
print(counts)
probs = counts / counts.sum(1, keepdim=True)
print(probs)
运行一下:
tensor([[ 1.5674, -0.2373, -0.0274,  ..., -0.0707,  2.4968,  2.4448],
        [ 0.4724,  1.4830,  0.3175,  ..., -0.4275, -2.1259,  0.9604],
        [ 0.1936,  1.0532,  0.6339,  ...,  1.5447,  0.6006, -0.7091],
        ...,
        [ 0.7414, -0.5879, -0.4651,  ..., -0.1388,  1.3096, -0.2580],
        [ 1.0669,  0.2136, -0.7660,  ...,  1.3405, -0.2175,  0.8627],
        [ 0.2163, -0.7873, -0.3301,  ..., -0.2630, -0.7552,  0.8191]])
tensor([[ 4.7940,  0.7888,  0.9730,  ...,  0.9317, 12.1434, 11.5281],
        [ 1.6038,  4.4060,  1.3737,  ...,  0.6521,  0.1193,  2.6128],
        [ 1.2136,  2.8669,  1.8850,  ...,  4.6866,  1.8232,  0.4921],
        ...,
        [ 2.0989,  0.5555,  0.6281,  ...,  0.8704,  3.7049,  0.7726],
        [ 2.9062,  1.2382,  0.4649,  ...,  3.8208,  0.8046,  2.3696],
        [ 1.2415,  0.4551,  0.7189,  ...,  0.7687,  0.4699,  2.2685]])
tensor([[0.0607, 0.0100, 0.0123,  ..., 0.0118, 0.1537, 0.1459],
        [0.0290, 0.0796, 0.0248,  ..., 0.0118, 0.0022, 0.0472],
        [0.0312, 0.0737, 0.0484,  ..., 0.1204, 0.0469, 0.0126],
        ...,
        [0.0301, 0.0080, 0.0090,  ..., 0.0125, 0.0531, 0.0111],
        [0.0634, 0.0270, 0.0101,  ..., 0.0833, 0.0175, 0.0517],
        [0.0308, 0.0113, 0.0178,  ..., 0.0190, 0.0116, 0.0562]])
可以看到,最后都是以概率的形式出现了,之后我们再计算输入的损失:
nlls = torch.zeros(5)
print(nlls)
for i in range(5):
    x = xs[i].item()
    y = ys[i].item()
    print('--------')
    print(f'二元组示例 {i + 1}: {itos[x]}{itos[y]} (索引 {x},{y})')
    print('神经网络的输入:', x)
    print('神经网络输出的概率分布:', probs[i])
    print('真实的下一个字符 (标签):', y)
    p = probs[i,y]
    print('网络赋予正确字符的概率:', p.item())
    logp = torch.log(p)
    print('对数似然:', logp.item())
    nll = -logp
    print('负对数似然 (损失):', nll.item())
    nlls[i] = nll

print('=========')
print('平均负对数似然,即损失 =', nlls.mean().item())
运行一下:
--------
二元组示例 1: .e (索引 0,5)
神经网络的输入: 0
神经网络输出的概率分布: tensor([0.0607, 0.0100, 0.0123, 0.0042, 0.0168, 0.0123, 0.0027, 0.0232, 0.0137,
        0.0313, 0.0079, 0.0278, 0.0091, 0.0082, 0.0500, 0.2378, 0.0603, 0.0025,
        0.0249, 0.0055, 0.0339, 0.0109, 0.0029, 0.0198, 0.0118, 0.1537, 0.1459])
真实的下一个字符 (标签): 5
网络赋予正确字符的概率: 0.01228625513613224
对数似然: -4.399273872375488
负对数似然 (损失): 4.399273872375488
--------
二元组示例 2: em (索引 5,13)
神经网络的输入: 5
神经网络输出的概率分布: tensor([0.0290, 0.0796, 0.0248, 0.0521, 0.1989, 0.0289, 0.0094, 0.0335, 0.0097,
        0.0301, 0.0702, 0.0228, 0.0115, 0.0181, 0.0108, 0.0315, 0.0291, 0.0045,
        0.0916, 0.0215, 0.0486, 0.0300, 0.0501, 0.0027, 0.0118, 0.0022, 0.0472])
真实的下一个字符 (标签): 13
网络赋予正确字符的概率: 0.018050700426101685
对数似然: -4.014570713043213
负对数似然 (损失): 4.014570713043213
--------
二元组示例 3: mm (索引 13,13)
神经网络的输入: 13
神经网络输出的概率分布: tensor([0.0312, 0.0737, 0.0484, 0.0333, 0.0674, 0.0200, 0.0263, 0.0249, 0.1226,
        0.0164, 0.0075, 0.0789, 0.0131, 0.0267, 0.0147, 0.0112, 0.0585, 0.0121,
        0.0650, 0.0058, 0.0208, 0.0078, 0.0133, 0.0203, 0.1204, 0.0469, 0.0126])
真实的下一个字符 (标签): 13
网络赋予正确字符的概率: 0.026691533625125885
对数似然: -3.623408794403076
负对数似然 (损失): 3.623408794403076
--------
二元组示例 4: ma (索引 13,1)
神经网络的输入: 13
神经网络输出的概率分布: tensor([0.0312, 0.0737, 0.0484, 0.0333, 0.0674, 0.0200, 0.0263, 0.0249, 0.1226,
        0.0164, 0.0075, 0.0789, 0.0131, 0.0267, 0.0147, 0.0112, 0.0585, 0.0121,
        0.0650, 0.0058, 0.0208, 0.0078, 0.0133, 0.0203, 0.1204, 0.0469, 0.0126])
真实的下一个字符 (标签): 1
网络赋予正确字符的概率: 0.07367686182260513
对数似然: -2.6080665588378906
负对数似然 (损失): 2.6080665588378906
--------
二元组示例 5: a. (索引 1,0)
神经网络的输入: 1
神经网络输出的概率分布: tensor([0.0150, 0.0086, 0.0396, 0.0100, 0.0606, 0.0308, 0.1084, 0.0131, 0.0125,
        0.0048, 0.1024, 0.0086, 0.0988, 0.0112, 0.0232, 0.0207, 0.0408, 0.0078,
        0.0899, 0.0531, 0.0463, 0.0309, 0.0051, 0.0329, 0.0654, 0.0503, 0.0091])
真实的下一个字符 (标签): 0
网络赋予正确字符的概率: 0.014977526850998402
对数似然: -4.201204299926758
负对数似然 (损失): 4.201204299926758
=========
平均负对数似然,即损失 = 3.7693049907684326
可以看到,对于前5个样本,我们这个完全随机的参数表,初始状态下,损失值是3.76,接下来我们应该对其进行微调,让其更加靠近这个样本集的损失值,也就是2.45左右
对参数进行反向传播
因为我们希望能够对W进行反向传播。因此,我们需要设置W参数requires_grad=True。我们先优化一下刚才的代码,通过矩阵和向量的方式一次性算出前5个样本的损失值:
words = open('names.txt','r').read().splitlines()
import torch
# 建立一个27×27的网格
N = torch.zeros((27, 27), dtype = torch.int32)

# 将姓名中出现的所有字母做成一个列表     chars = ['a','b','c','d','e' ...]
chars = sorted(list(set(''.join(words))))
# 我们希望把第0个位置让给开启或结束占位符'.'       stoi = {'a': 1, 'b': 2, 'c': 3, 'd': 4, 'e': 5 ...}
stoi = {s:i+1 for i, s in enumerate(chars)}
stoi['.'] = 0
# 建立反向索引        itos = {0: '.', 1: 'a', 2: 'b', 3: 'c', ...}
itos = {i: s for s, i in stoi.items()}

xs, ys = [], []
for word in words:
    chs = ['.'] + list(word) + ['.']
    for ch1, ch2 in zip(chs, chs[1:]):
        ix1 = stoi[ch1]
        ix2 = stoi[ch2]
        # print(ch1, ch2, ix1, ix2)
        xs.append(ix1)
        ys.append(ix2)

xs = torch.tensor(xs)
ys = torch.tensor(ys)

import torch.nn.functional as F
g = torch.Generator().manual_seed(2147483647)
W = torch.randn((27, 27), generator=g, requires_grad=True)
xenc = F.one_hot(xs, num_classes=27).float()

logits = xenc @ W
counts = logits.exp()
probs = counts / counts.sum(1, keepdim=True)

row_indices = torch.arange(5)
print(row_indices)
corrent_probs = probs[row_indices, ys[:5]]
print(corrent_probs)
log_corrent_probs = torch.log(corrent_probs)
print(log_corrent_probs)
mean_log_probs = log_corrent_probs.mean()
print(mean_log_probs)
loss = -mean_log_probs
print(loss.item())
之后我们再让loss进行反向传播,计算出W中每一个参数的梯度,并且通过微调参数的方式来训练,我们先训练一次,看看损失有没有下降:
W.grad = None
loss.backward()
W.data += -0.1 * W.grad

logits = xenc @ W
counts = logits.exp()
probs = counts / counts.sum(1, keepdim=True)
row_indices = torch.arange(5)
print(row_indices)
corrent_probs = probs[row_indices, ys[:5]]
print(corrent_probs)
log_corrent_probs = torch.log(corrent_probs)
print(log_corrent_probs)
mean_log_probs = log_corrent_probs.mean()
print(mean_log_probs)
loss = -mean_log_probs
print(loss.item())
运行一下:
tensor([0, 1, 2, 3, 4])
tensor([0.0123, 0.0181, 0.0267, 0.0737, 0.0150], grad_fn=<IndexBackward0>)
tensor([-4.3993, -4.0146, -3.6234, -2.6081, -4.2012], grad_fn=<LogBackward0>)
tensor(-3.7693, grad_fn=<MeanBackward0>)
3.7693049907684326
tensor([0, 1, 2, 3, 4])
tensor([0.0126, 0.0184, 0.0272, 0.0750, 0.0153], grad_fn=<IndexBackward0>)
tensor([-4.3774, -3.9937, -3.6039, -2.5905, -4.1805], grad_fn=<LogBackward0>)
tensor(-3.7492, grad_fn=<MeanBackward0>)
3.7492127418518066
可以看到,经过一次微调,损失值从3.76变成了3.74,说明我们这个步骤是有效的。接下来我们再对这个训练步骤进行优化,并且循环反向传播5次:
words = open('names.txt','r').read().splitlines()
import torch
# 建立一个27×27的网格
N = torch.zeros((27, 27), dtype = torch.int32)

# 将姓名中出现的所有字母做成一个列表     chars = ['a','b','c','d','e' ...]
chars = sorted(list(set(''.join(words))))
# 我们希望把第0个位置让给开启或结束占位符'.'       stoi = {'a': 1, 'b': 2, 'c': 3, 'd': 4, 'e': 5 ...}
stoi = {s:i+1 for i, s in enumerate(chars)}
stoi['.'] = 0
# 建立反向索引        itos = {0: '.', 1: 'a', 2: 'b', 3: 'c', ...}
itos = {i: s for s, i in stoi.items()}

xs, ys = [], []
for word in words:
    chs = ['.'] + list(word) + ['.']
    for ch1, ch2 in zip(chs, chs[1:]):
        ix1 = stoi[ch1]
        ix2 = stoi[ch2]
        # print(ch1, ch2, ix1, ix2)
        xs.append(ix1)
        ys.append(ix2)

xs = torch.tensor(xs)
ys = torch.tensor(ys)
num = xs.nelement()
print(f"样本数量:{num}")

import torch.nn.functional as F
g = torch.Generator().manual_seed(2147483647)
W = torch.randn((27, 27), generator=g, requires_grad=True)
xenc = F.one_hot(xs, num_classes=27).float()

for i in range(5):
    logits = xenc @ W
    counts = logits.exp()
    probs = counts / counts.sum(1, keepdim=True)
    loss = -probs[torch.arange(num), ys].log().mean()
    print(loss.item())

    W.grad = None
    loss.backward()
    W.data += -0.1 * W.grad

logits = xenc @ W
counts = logits.exp()
probs = counts / counts.sum(1, keepdim=True)
loss = -probs[torch.arange(num), ys].log().mean()
print(loss.item())
运行一下:
样本数量:228146
3.758953809738159
3.758040428161621
3.7571277618408203
3.756216049194336
3.7553062438964844
3.754396915435791
可以看到损失值正在稳定地下降。
让模型输出
我们当然还需要一个方法,让微调之后的模型输出名字,并且让反向传播的次数增加到50次,让这个模型的损失值尽可能的低,以下是完整代码:
words = open('names.txt','r').read().splitlines()
import torch
# 建立一个27×27的网格
N = torch.zeros((27, 27), dtype = torch.int32)

# 将姓名中出现的所有字母做成一个列表     chars = ['a','b','c','d','e' ...]
chars = sorted(list(set(''.join(words))))
# 我们希望把第0个位置让给开启或结束占位符'.'       stoi = {'a': 1, 'b': 2, 'c': 3, 'd': 4, 'e': 5 ...}
stoi = {s:i+1 for i, s in enumerate(chars)}
stoi['.'] = 0
# 建立反向索引        itos = {0: '.', 1: 'a', 2: 'b', 3: 'c', ...}
itos = {i: s for s, i in stoi.items()}

xs, ys = [], []
for word in words:
    chs = ['.'] + list(word) + ['.']
    for ch1, ch2 in zip(chs, chs[1:]):
        ix1 = stoi[ch1]
        ix2 = stoi[ch2]
        # print(ch1, ch2, ix1, ix2)
        xs.append(ix1)
        ys.append(ix2)

xs = torch.tensor(xs)
ys = torch.tensor(ys)
num = xs.nelement()
print(f"样本数量:{num}")

import torch.nn.functional as F
g = torch.Generator().manual_seed(2147483647)
W = torch.randn((27, 27), generator=g, requires_grad=True)
xenc = F.one_hot(xs, num_classes=27).float()

for i in range(100):
    logits = xenc @ W
    counts = logits.exp()
    probs = counts / counts.sum(1, keepdim=True)
    loss = -probs[torch.arange(num), ys].log().mean()
    if i % 10 == 0:
        print(loss.item())

    W.grad = None
    loss.backward()
    W.data += -50 * W.grad

logits = xenc @ W
counts = logits.exp()
probs = counts / counts.sum(1, keepdim=True)
loss = -probs[torch.arange(num), ys].log().mean()
print(loss.item())

for i in range(5):
    out = []
    ix = 0
    while True:
        xenc = F.one_hot(torch.tensor([ix]), num_classes=27).float()
        logits = xenc @ W
        counts = logits.exp()
        probs = counts / counts.sum(1, keepdim=True) # 下一个字符出现的概率,这个地方应该是一个有27个元素的列表

        # 手动从一个列表中随机出一个下标
        ix = torch.multinomial(probs, num_samples=1, replacement=True,generator=g).item()
        out.append(itos[ix])
        if ix == 0:
            break

    print("".join(out))
运行如下:
样本数量:228146
3.758953809738159
2.6890034675598145
2.572789430618286
2.5301806926727295
2.5086867809295654
2.496137857437134
2.4880495071411133
2.482424736022949
2.478290557861328
2.475132942199707
2.4726526737213135
jigla.
sadryrolyiniydavesole.
rish.
be.
ka.
可以看到我们这个模型的损失值已经逼近了样本的损失值。并且输出了名字,虽然并不是很成功,因为我们的模型只考虑了上一个字符的可能性。
结语
我们这次实现的是一个单层线性模型,其输入是27个输入值,而其输出也必须是27个输出值,因此其可训练参数是729个,通过这729个可训练参数,我们尽可能地拟合了那张27×27的概率分布表格,如果我们想增加其参数的话,就只能增加其中间层(隐藏层),不过,对于我们的这个目标,可能并不需要如此复杂,并且当前已经基本上达到了这个设计模型的逻辑的上限,其损失值已经逼近了极限,因此我们并不需要更加复杂的方式来实现了。


很有帮助