这是Andrej Karpathy 零基础学习神经网络的视频课的第七节课。本次我们将会学习如何搭建一个Transformer架构的语言模型。
准备工作
安装Python
安装Pytorch
观看视频课程
正式开始编写代码
引入必要包和固定随机种子
经典的第一步,引入必须使用的包,并且固定随机种子:
import torch
import torch.nn as nn
from torch.nn import functional as F
torch.manual_seed(1337)
引入文件并提取出字符
引入我们用于训练的莎士比亚文本集文件,并且将文件中出现的所有字符提取出来:
with open('input.txt', 'r', encoding='utf-8') as f:
    text = f.read()
chars = sorted(list(set(text)))
vocab_size = len(chars)
print(''.join(chars))
print(vocab_size)
输出:
 !$&',-.3:;?ABCDEFGHIJKLMNOPQRSTUVWXYZabcdefghijklmnopqrstuvwxyz
65
可以看到,一共有65种不同的字符。
编写编码器、解码器
接下来我们把编码器和解码器写出来:
stoi = { ch:i for i,ch in enumerate(chars) }
itos = {i:ch for i,ch in enumerate(chars)}
encode = lambda s: [stoi[c] for c in s]
decode = lambda l: ''.join([itos[i] for i in l])

print(encode("hii there"))
print(decode(encode("hii there")))
输出:
[46, 47, 47, 1, 58, 46, 43, 56, 43]
hii there
可见,我们的编码器和解码器已经正常工作了。
将文本转化为一维向量,并切割训练集和验证集
接下来,我们将整个莎士比亚文本集转化为一维向量,并且将其按9:1的比例划分为训练集和验证集:
# 将数据转为一维张量
data = torch.tensor(encode(text), dtype=torch.long)
print(data.shape, data.dtype)
print(data[:1000])

# 将数据分为训练集和验证集
n = int(0.9*len(data))
train_data = data[:n]
val_data = data[n:]
输出:
torch.Size([1115394]) torch.int64
tensor([18, 47, 56, 57, 58,  1, 15, 47, 58, 47, 64, 43, 52, 10,  0, 14, 43, 44,
        53, 56, 43,  1, 61, 43,  1, 54, 56, 53, 41, 43, 43, 42,  1, 39, 52, 63,
         1, 44, 59, 56, 58, 46, 43, 56,  6,  1, 46, 43, 39, 56,  1, 51, 43,  1,...
加工训练样本
对于我们训练模型,我们提供的样本是这样的:
block_size = 8
print(train_data[:block_size+1])

x = train_data[:block_size]
y = train_data[1:block_size+1]
for t in range(block_size):
    context = x[:t+1]
    target = y[t]
    print(context)
    print(target)
输出:
tensor([18, 47, 56, 57, 58,  1, 15, 47, 58])
tensor([18])
tensor(47)
tensor([18, 47])
tensor(56)
tensor([18, 47, 56])
tensor(57)
tensor([18, 47, 56, 57])
tensor(58)
tensor([18, 47, 56, 57, 58])
tensor(1)
tensor([18, 47, 56, 57, 58,  1])
tensor(15)
tensor([18, 47, 56, 57, 58,  1, 15])
tensor(47)
tensor([18, 47, 56, 57, 58,  1, 15, 47])
tensor(58)
模型学习[18]之后输出47,学习[18, 47]之后输出56,以此类推。
根据这个思想,我们可以让GPU并行的处理并学习,比如接下来我们可以编写代码,同时准备4组训练样本:
batch_size = 4 # 批次大小
block_size = 8 # 块大小
def get_batch(split):
    data = train_data if split == 'train' else val_data # 区分加载训练集还是验证集
    ix = torch.randint(len(data) - block_size,(batch_size,)) # 随机起点
    x = torch.stack([data[i:i+block_size] for i in ix])
    y = torch.stack([data[i+1:i+block_size+1] for i in ix])
    return x,y

xb,yb = get_batch('train')
print('input:')
print(xb.shape)
print(xb)
print('output:')
print(yb.shape)
print(yb)

print('------')

for b in range(batch_size):
    for t in range(block_size):
        context = xb[b, :t+1]
        target = yb[b,t]
        print(f'context: {context}, target: {target}')
输出:
input:
torch.Size([4, 8])
tensor([[24, 43, 58,  5, 57,  1, 46, 43],
        [44, 53, 56,  1, 58, 46, 39, 58],
        [52, 58,  1, 58, 46, 39, 58,  1],
        [25, 17, 27, 10,  0, 21,  1, 54]])
output:
torch.Size([4, 8])
tensor([[43, 58,  5, 57,  1, 46, 43, 39],
        [53, 56,  1, 58, 46, 39, 58,  1],
        [58,  1, 58, 46, 39, 58,  1, 46],
        [17, 27, 10,  0, 21,  1, 54, 39]])
------
context: tensor([24]), target: 43
context: tensor([24, 43]), target: 58
context: tensor([24, 43, 58]), target: 5
context: tensor([24, 43, 58,  5]), target: 57
context: tensor([24, 43, 58,  5, 57]), target: 1
context: tensor([24, 43, 58,  5, 57,  1]), target: 46
context: tensor([24, 43, 58,  5, 57,  1, 46]), target: 43
context: tensor([24, 43, 58,  5, 57,  1, 46, 43]), target: 39
context: tensor([44]), target: 53
context: tensor([44, 53]), target: 56
context: tensor([44, 53, 56]), target: 1
context: tensor([44, 53, 56,  1]), target: 58
context: tensor([44, 53, 56,  1, 58]), target: 46
context: tensor([44, 53, 56,  1, 58, 46]), target: 39
context: tensor([44, 53, 56,  1, 58, 46, 39]), target: 58
context: tensor([44, 53, 56,  1, 58, 46, 39, 58]), target: 1
context: tensor([52]), target: 58
context: tensor([52, 58]), target: 1
context: tensor([52, 58,  1]), target: 58
context: tensor([52, 58,  1, 58]), target: 46
context: tensor([52, 58,  1, 58, 46]), target: 39
context: tensor([52, 58,  1, 58, 46, 39]), target: 58
context: tensor([52, 58,  1, 58, 46, 39, 58]), target: 1
context: tensor([52, 58,  1, 58, 46, 39, 58,  1]), target: 46
context: tensor([25]), target: 17
context: tensor([25, 17]), target: 27
context: tensor([25, 17, 27]), target: 10
context: tensor([25, 17, 27, 10]), target: 0
context: tensor([25, 17, 27, 10,  0]), target: 21
context: tensor([25, 17, 27, 10,  0, 21]), target: 1
context: tensor([25, 17, 27, 10,  0, 21,  1]), target: 54
context: tensor([25, 17, 27, 10,  0, 21,  1, 54]), target: 39
实现二元语言模型
这个地方,我也理解了很久,我先把代码贴上来:
class BigramLanguageModel(nn.Module):

    def __init__(self, vocab_size):
        super().__init__()
        self.token_embedding_table = nn.Embedding(vocab_size, vocab_size)

    def forward(self, idx, targets):

        logits = self.token_embedding_table(idx)

        return logits

m = BigramLanguageModel(vocab_size)
out = m(xb,yb)
print(out.shape)
输出:
torch.Size([4, 8, 65])解释一下,首先看一下xb的样子:
tensor([[24, 43, 58,  5, 57,  1, 46, 43],
        [44, 53, 56,  1, 58, 46, 39, 58],
        [52, 58,  1, 58, 46, 39, 58,  1],
[25, 17, 27, 10, 0, 21, 1, 54]])可以看到,xb是一个4×8的矩阵。由于nn.Module 实现了 __call__,所以 m(...) 会自动转去调 forward。所以m(xb,yb)实际上是调用了forward方法。
想象一本册子,65 页,每页对应一个字符。翻到 h 那一页,上面写着 65 行小字:
接 a 的可能性:0.4
接 b 的可能性:-1.2
...
接 e 的可能性:3.7   ← 最高
...
接 z 的可能性:-0.8
这一整页,就是 65 个数。 你给一个字符编号,它把那一页原样撕给你。就这么简单,没有任何计算。这就是self.token_embedding_table(idx) 干的事,就是 拿着 idx 里的每个编号去翻页。
关键难点:idx 不是一个数,是一个方块
如果 idx 只是单个整数 46,那返回一页 65 个数,好理解。
但 idx 是 xb,形状 (4, 8) —— 32 个整数排成的方块。于是 Embedding 要翻 32 次页,返回 32 页。
这 32 页怎么摆? PyTorch 的规则是:原来每个整数待的位置,现在变成一页纸插在那儿。
所以out的形状就变成了4x8x65了。
完善前项传播方法
接着我们完善一下forward方法,把损失值算出来:
class BigramLanguageModel(nn.Module):

    def __init__(self, vocab_size):
        super().__init__()
        self.token_embedding_table = nn.Embedding(vocab_size, vocab_size)

    def forward(self, idx, targets):

        logits = self.token_embedding_table(idx)

        B, T, C = logits.shape
        logits = logits.view(B*T,C)
        targets = targets.view(B*T)
        loss = F.cross_entropy(logits, targets)
        return logits, loss

m = BigramLanguageModel(vocab_size)
logits, loss = m(xb,yb)
print(logits.shape)
print(loss)
输出:
torch.Size([32, 65])
tensor(5.0364, grad_fn=<NllLossBackward0>)
可以看到初始损失是5.0364。其中这一步:logits = logits.view(B*T,C),把三维拍扁成二维,因为F.cross_entropy 有严格的输入格式要求:
- 预测:
(N, C)—— N 道题,每题 C 个选项的得分 - 答案:
(N,)—— N 个正确选项的编号
而我们手上是 (4, 8, 65) 三维,它不收。
但仔细想想:(4, 8) 这两维其实没有本质区别。4 是”哪一段”,8 是”段里第几个字符”——对 loss 来说,这 32 个位置就是 32 道彼此独立的选择题,来自哪一段、排第几位,统统不重要。
所以把前两维揉成一维就行:
logits:  (4, 8, 65)  →  (32, 65)
targets: (4, 8)      →  (32,)
view 只是换一种方式看同一块内存,不复制数据,不改变任何数值,纯粹是重新解释形状。所以,基本上也没有什么时间损失。
实现输出方法
接着我们实现一下generate方法,让这个还没有被训练过的模型能够输出:
class BigramLanguageModel(nn.Module):

    def __init__(self, vocab_size):
        super().__init__()
        self.token_embedding_table = nn.Embedding(vocab_size, vocab_size)

    def forward(self, idx, targets=None):

        logits = self.token_embedding_table(idx)

        if targets is None:
            loss = None
        else:
            B, T, C = logits.shape
            logits = logits.view(B * T, C)
            targets = targets.view(B * T)
            loss = F.cross_entropy(logits, targets)

        return logits, loss

    def generate(self, idx, max_new_token):
        for _ in range(max_new_token):
            logits , loss = self.forward(idx)
            logits = logits[:, -1, :]
            probs = F.softmax(logits, dim=-1)
            idx_next = torch.multinomial(probs, num_samples=1)
            idx = torch.cat((idx, idx_next), dim = 1)
        return idx

m = BigramLanguageModel(vocab_size)
logits, loss = m(xb,yb)
print(logits.shape)
print(loss)

idx = torch.zeros((1, 1), dtype=torch.long)
code = m.generate(idx, max_new_token=100)
print(decode(code[0].tolist()))
输出:
lfJeukRuaRJKXAYtXzfJ:HEPiu--sDioi;ILCo3pHNTmDwJsfheKRxZCFs
lZJ XQc?:s:HEzEnXalEPklcPU cL'DpdLCafBheH可以看到,这个完全未经训练的模型输出的是一团乱码。generate方法的核心思路其实就是:猜一个字 → 接到末尾 → 拿新序列再猜下一个,循环往复。起始是一个1×1的张量:idx = torch.zeros((1, 1), dtype=torch.long),也就是起始符。
训练模型
接下来我们用Adam方法来训练模型,先把学习率调为0.001,训练10000次,然后看看输出,以下是当前所需的完整代码:
import torch
import torch.nn as nn
from torch.nn import functional as F
torch.manual_seed(1337)

with open('input.txt', 'r', encoding='utf-8') as f:
    text = f.read()
chars = sorted(list(set(text)))
vocab_size = len(chars)

stoi = { ch:i for i,ch in enumerate(chars) }
itos = {i:ch for i,ch in enumerate(chars)}
encode = lambda s: [stoi[c] for c in s]
decode = lambda l: ''.join([itos[i] for i in l])


# 将数据转为一维张量
data = torch.tensor(encode(text), dtype=torch.long)

# 将数据分为训练集和验证集
n = int(0.9*len(data))
train_data = data[:n]
val_data = data[n:]

batch_size = 4 # 批次大小
block_size = 8 # 块大小
def get_batch(split):
    data = train_data if split == 'train' else val_data # 区分加载训练集还是验证集
    ix = torch.randint(len(data) - block_size,(batch_size,)) # 随机起点
    x = torch.stack([data[i:i+block_size] for i in ix])
    y = torch.stack([data[i+1:i+block_size+1] for i in ix])
    return x,y

class BigramLanguageModel(nn.Module):

    def __init__(self, vocab_size):
        super().__init__()
        self.token_embedding_table = nn.Embedding(vocab_size, vocab_size)

    def forward(self, idx, targets=None):

        logits = self.token_embedding_table(idx)

        if targets is None:
            loss = None
        else:
            B, T, C = logits.shape
            logits = logits.view(B * T, C)
            targets = targets.view(B * T)
            loss = F.cross_entropy(logits, targets)

        return logits, loss

    def generate(self, idx, max_new_token):
        for _ in range(max_new_token):
            logits , loss = self.forward(idx)
            logits = logits[:, -1, :]
            probs = F.softmax(logits, dim=-1)
            idx_next = torch.multinomial(probs, num_samples=1)
            idx = torch.cat((idx, idx_next), dim = 1)
        return idx

m = BigramLanguageModel(vocab_size)

optimizer = torch.optim.Adam(m.parameters(), lr=1e-3)

batch_size = 32
for steps in range(10000):
    xb, yb = get_batch('train')

    logits ,loss = m(xb, yb)
    optimizer.zero_grad(set_to_none=True)
    loss.backward()
    optimizer.step()

xb, yb = get_batch('train')
logits ,loss = m(xb, yb)
print('loss: ', loss.item())
idx = torch.zeros((1, 1), dtype=torch.long)
code = m.generate(idx, max_new_token=100)
print(decode(code[0].tolist()))
输出:
loss:  2.46570086479187

GLOMur.
FRora?
IEDUMBuselofor;
Touthery the, mor, athe y ho!
Whore aco tur! ms
LI'd che, gat f hou w
可以看到损失值降到了2.46,输出的也比之前要好了,但是由于这个是一个二元模型,每次输出只看前面的一个字符,导致效果不好,所以我们接下来需要让字符之间有联系。
提高损失计算准确度
单个 batch 的 loss 噪声太大,会导致损失值不是普遍现象,所以我们可以连抽 200 个 batch,取平均:
@torch.no_grad()
def estimate_loss():
    out = {}
    model.eval()
    for split in ['train', 'val']:
        losses = torch.zeros(eval_iters)
        for k in range(eval_iters):
            X, Y = get_batch(split)
            logits, loss = model(X, Y)
            losses[k] = loss.item()
        out[split] = losses.mean()
    model.train()
    return out
另外,我们对代码进行一些优化,并且在可能的情况下使用GPU。以下是当前的完整代码:
import torch
import torch.nn as nn
from torch.nn import functional as F
torch.manual_seed(1337)

batch_size = 32 # 批次大小
block_size = 8 # 块大小
max_iters = 3000
eval_interval = 300
learning_rate = 1e-3
device = 'cuda' if torch.cuda.is_available() else 'cpu'
eval_iters = 200
n_embd = 32

with open('input.txt', 'r', encoding='utf-8') as f:
    text = f.read()
chars = sorted(list(set(text)))
vocab_size = len(chars)

stoi = { ch:i for i,ch in enumerate(chars) }
itos = {i:ch for i,ch in enumerate(chars)}
encode = lambda s: [stoi[c] for c in s]
decode = lambda l: ''.join([itos[i] for i in l])


# 将数据转为一维张量
data = torch.tensor(encode(text), dtype=torch.long)

# 将数据分为训练集和验证集
n = int(0.9*len(data))
train_data = data[:n]
val_data = data[n:]


def get_batch(split):
    data = train_data if split == 'train' else val_data # 区分加载训练集还是验证集
    ix = torch.randint(len(data) - block_size,(batch_size,)) # 随机起点
    x = torch.stack([data[i:i+block_size] for i in ix])
    y = torch.stack([data[i+1:i+block_size+1] for i in ix])
    x,y = x.to(device), y.to(device)
    return x,y

@torch.no_grad()
def estimate_loss():
    out = {}
    model.eval()
    for split in ['train', 'val']:
        losses = torch.zeros(eval_iters)
        for k in range(eval_iters):
            X, Y = get_batch(split)
            logits, loss = model(X, Y)
            losses[k] = loss.item()
        out[split] = losses.mean()
    model.train()
    return out

class BigramLanguageModel(nn.Module):

    def __init__(self):
        super().__init__()
        self.token_embedding_table = nn.Embedding(vocab_size, vocab_size)

    def forward(self, idx, targets=None):

        logits = self.token_embedding_table(idx)

        if targets is None:
            loss = None
        else:
            B, T, C = logits.shape
            logits = logits.view(B * T, C)
            targets = targets.view(B * T)
            loss = F.cross_entropy(logits, targets)

        return logits, loss

    def generate(self, idx, max_new_token):
        for _ in range(max_new_token):
            logits , loss = self.forward(idx)
            logits = logits[:, -1, :]
            probs = F.softmax(logits, dim=-1)
            idx_next = torch.multinomial(probs, num_samples=1)
            idx = torch.cat((idx, idx_next), dim = 1)
        return idx

model = BigramLanguageModel()
m = model.to(device)

optimizer = torch.optim.Adam(m.parameters(), lr=learning_rate)

for steps in range(max_iters):
    if steps % eval_interval == 0:
        losses = estimate_loss()
        print(f"step {steps}: train loss {losses['train']:.4f}, val loss {losses['val']:.4f}")
    xb, yb = get_batch('train')

    logits ,loss = m(xb, yb)
    optimizer.zero_grad(set_to_none=True)
    loss.backward()
    optimizer.step()

xb, yb = get_batch('train')
logits ,loss = m(xb, yb)
print('loss: ', loss.item())
idx = torch.zeros((1, 1), dtype=torch.long, device=device)
code = m.generate(idx, max_new_token=100)
print(decode(code[0].tolist()))
跑起来看看输出:
step 0: train loss 4.7305, val loss 4.7241
step 300: train loss 4.3844, val loss 4.3922
step 600: train loss 4.0840, val loss 4.0824
step 900: train loss 3.8108, val loss 3.8160
step 1200: train loss 3.5885, val loss 3.5890
step 1500: train loss 3.3789, val loss 3.3861
step 1800: train loss 3.2206, val loss 3.2242
step 2100: train loss 3.0832, val loss 3.0824
step 2400: train loss 2.9669, val loss 2.9746
step 2700: train loss 2.8807, val loss 2.8798
loss:  2.7016472816467285


CExfikRO:
wcowi,STAOLOL, btK

HAPTombobeAUGe.
SGJO-33SM:C?YIUauss:LVXEthafNusqhathe.t?ar dXlaSpate
数学铺垫
接下来,这里需要做一点数学铺垫,关于如何计算平均值:
假设 x 是 3 个字符,每个字符用二维向量表示:
x = [[10, 20],
     [30, 40],
     [50, 60]]
我们想要得到每个字符和其前面的字符的向量的平均值:
xbow[0] = [10, 20]              就是 x[0]
xbow[1] = [20, 30]              (x[0]+x[1])/2
xbow[2] = [30, 40]              (x[0]+x[1]+x[2])/3
根据矩阵乘法的规则,我们可以这样实现:
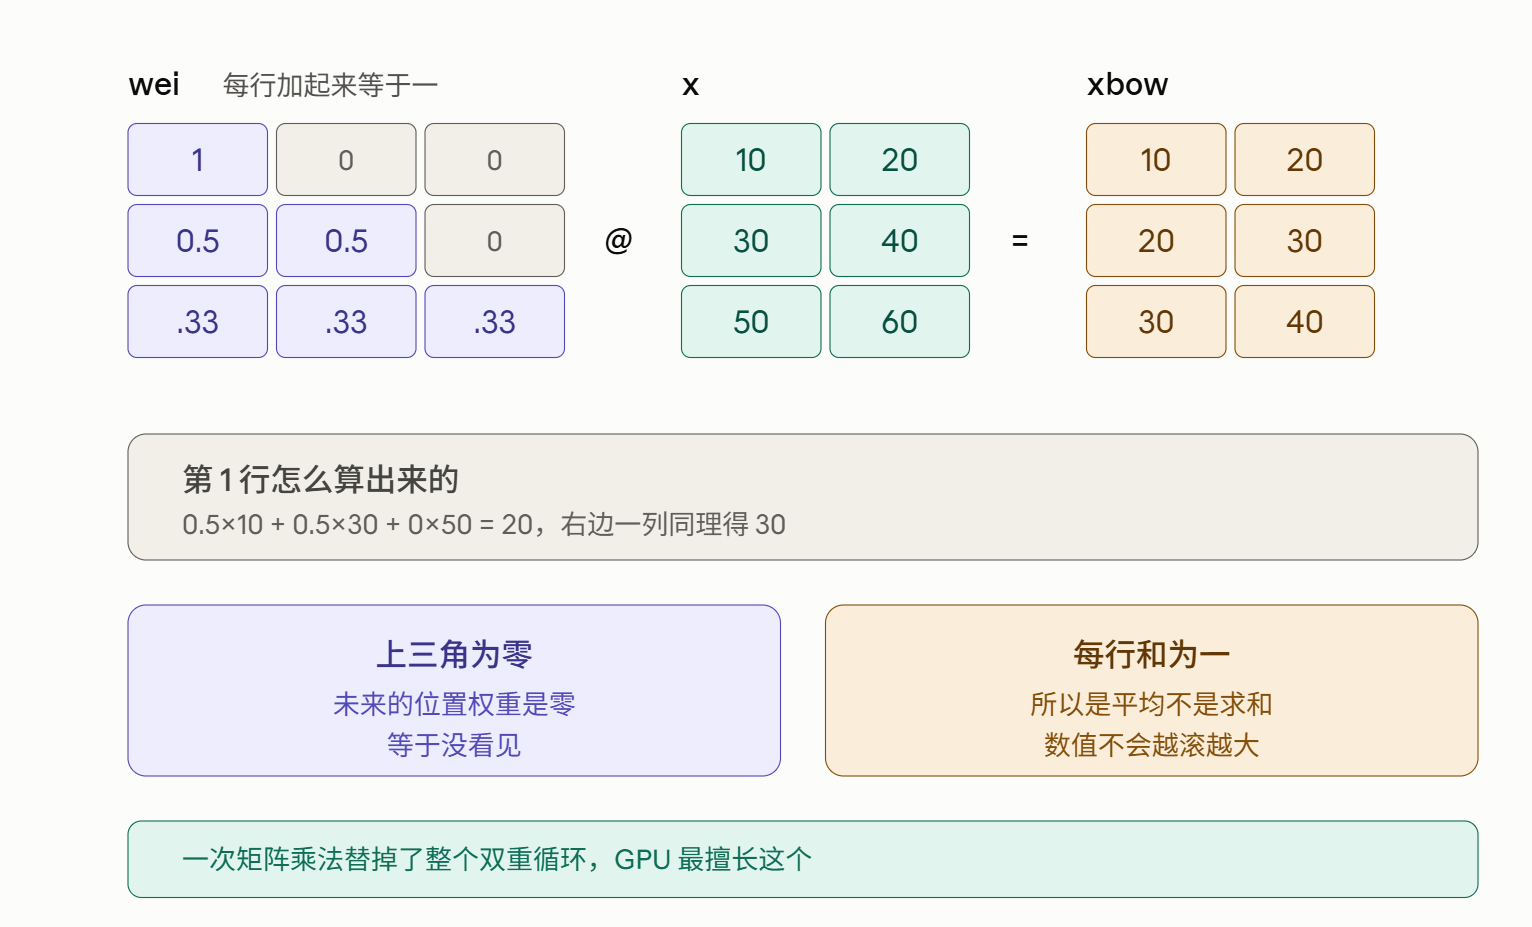
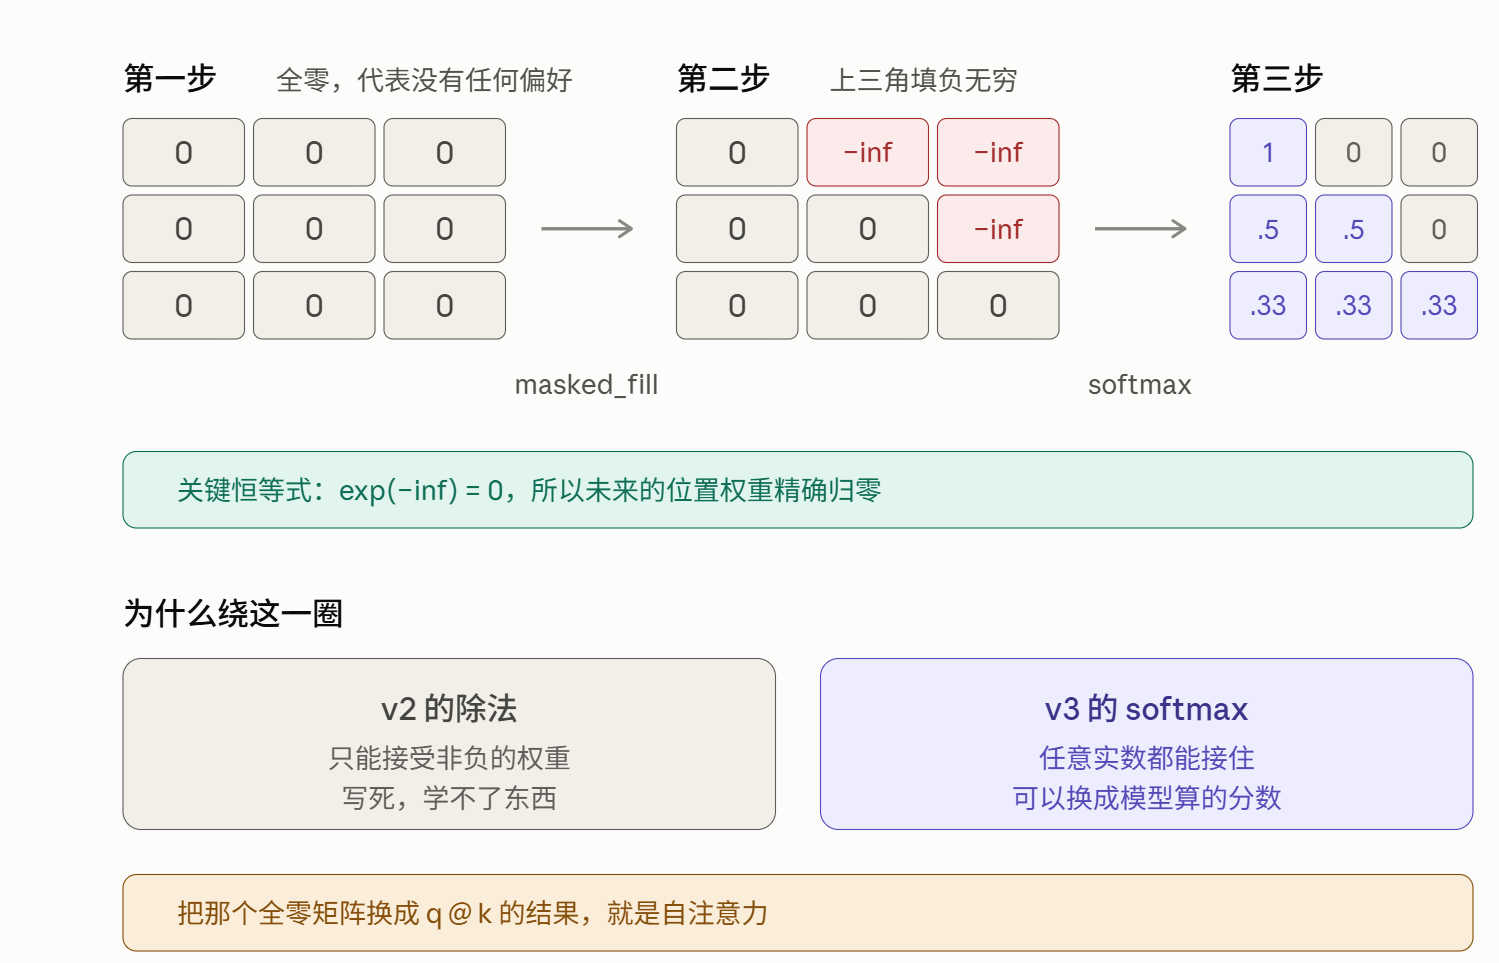
但是这个地方wei矩阵它的权重都写死了,我们希望它的权重由模型自己进行算出来,每个位置自己决定关注谁。所以我们可以把wei矩阵的右上部分都设置为无穷小,之后调用softmax方法,在softmax方法中,先的每一个位置求指数,那么为0的位置求指数之后就是1,而无穷小的位置求指数之后就是0:
增加位置信息
现在还是只有一个65*65的矩阵,用于表示每一个字符之后所有字符的可能性,现在我们要把这个矩阵拆开,把attention 装在这里:
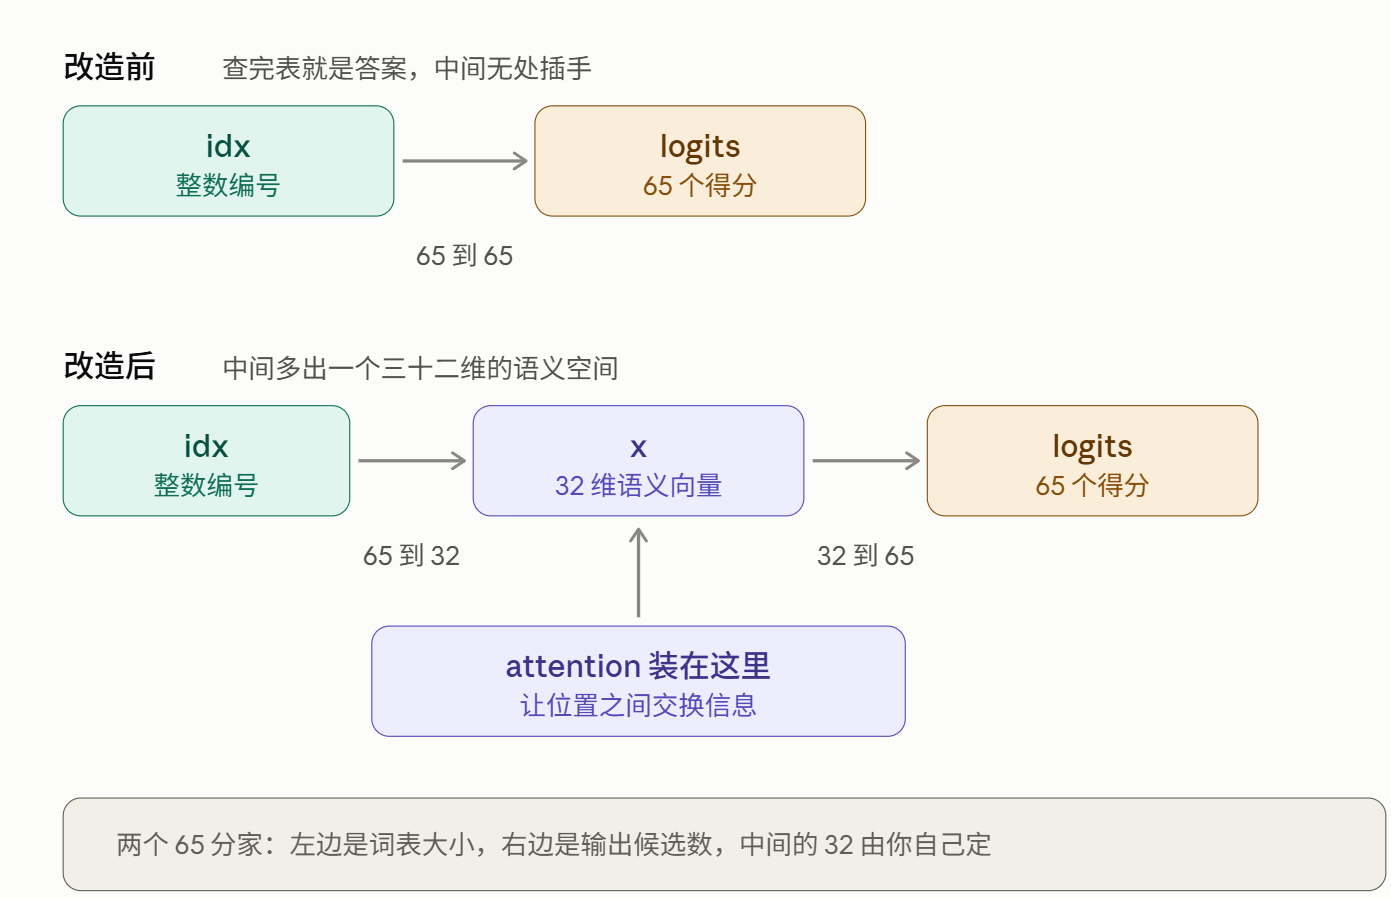
之前每个字符对应的是65 个得分,现在对应的是32 个数。这 32 个数没有预设含义,是模型自己学出来的特征。但是还缺一样东西:位置信息,”abc” 和 “cba” 平均出来一模一样,所以要单独喂一份位置信息:
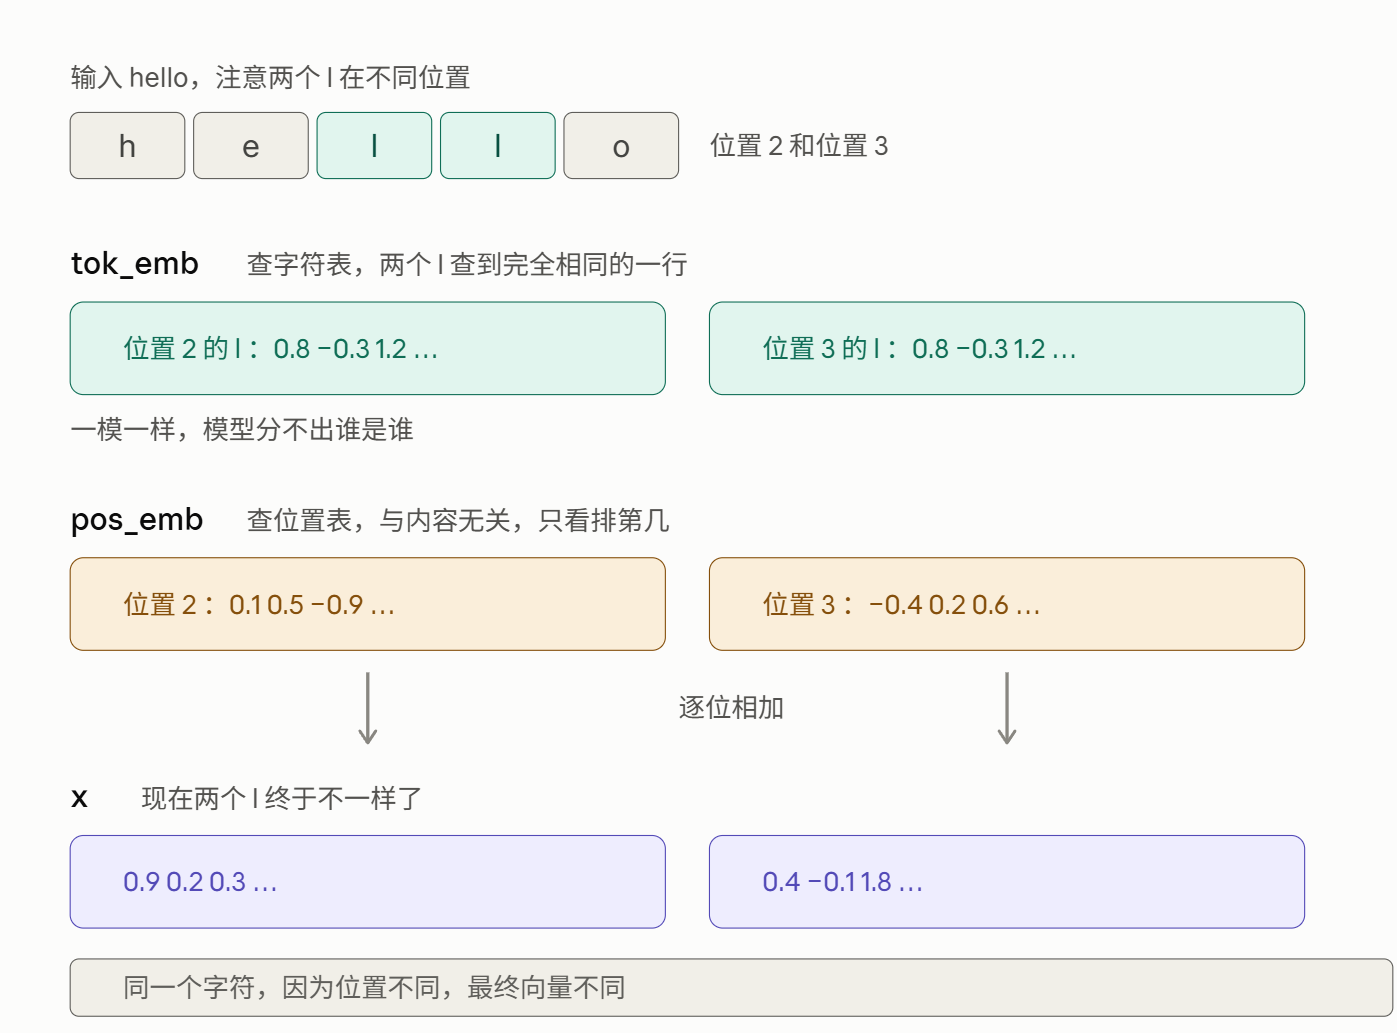
这是改造后的BigramLanguageModel类:
class BigramLanguageModel(nn.Module):

    def __init__(self):
        super().__init__()
        self.token_embedding_table = nn.Embedding(vocab_size, n_embd) # (65, 32)
        self.position_embedding_table = nn.Embedding(block_size, n_embd) # (8, 32)
        self.lm_head = nn.Linear(n_embd, vocab_size)

    def forward(self, idx, targets=None):
        B, T = idx.shape # B=4、T=8
        tok_emb = self.token_embedding_table(idx) # (4, 8, 32)
        pos_emb = self.position_embedding_table(torch.arange(T, device=device)) # (8, 32)
        x = tok_emb + pos_emb # (4, 8, 32) + (8, 32)  ->  (4, 8, 32) + (1, 8, 32) -> (4, 8, 32)
        logits = self.lm_head(x) # (4, 8, 32) → (4, 8, 65)

        if targets is None:
            loss = None
        else:
            B, T, C = logits.shape
            logits = logits.view(B * T, C)
            targets = targets.view(B * T)
            loss = F.cross_entropy(logits, targets)

        return logits, loss

    def generate(self, idx, max_new_token):
        for _ in range(max_new_token):
            idx_cond = idx[:, -block_size:]
            logits , loss = self.forward(idx_cond)
            logits = logits[:, -1, :]
            probs = F.softmax(logits, dim=-1)
            idx_next = torch.multinomial(probs, num_samples=1)
            idx = torch.cat((idx, idx_next), dim = 1)
        return idx
增加自注意力头与多头注意力
我们现在来实现一个Head类,用来实现自注意力头:
class Head(nn.Module):
    def __init__(self, head_size):
        super().__init__()
        self.key = nn.Linear(n_embd, head_size, bias=False)
        self.query = nn.Linear(n_embd, head_size, bias=False)
        self.value = nn.Linear(n_embd, head_size, bias=False)
        self.register_buffer('tril', torch.tril(torch.ones(block_size, block_size)))

    def forward(self, x):
        B, T, C = x.shape
        k = self.key(x)
        q = self.query(x)

        wei = q @ k.transpose(-2, -1) * k.shape[-1]**-0.5
        wei = wei.masked_fill(self.tril[:T, :T] == 0, float('-inf'))
        wei = F.softmax(wei, dim=-1)

        v = self.value(x)
        out = wei @ v
        return out
我们将自注意力头加入到BigramLanguageModel中,以下是完整代码:
import torch
import torch.nn as nn
from torch.nn import functional as F
torch.manual_seed(1337)

batch_size = 4 # 批次大小
block_size = 8 # 块大小
max_iters = 5000
eval_interval = 300
learning_rate = 1e-3
device = 'cuda' if torch.cuda.is_available() else 'cpu'
eval_iters = 200
n_embd = 32

with open('input.txt', 'r', encoding='utf-8') as f:
    text = f.read()
chars = sorted(list(set(text)))
vocab_size = len(chars)

stoi = { ch:i for i,ch in enumerate(chars) }
itos = {i:ch for i,ch in enumerate(chars)}
encode = lambda s: [stoi[c] for c in s]
decode = lambda l: ''.join([itos[i] for i in l])


# 将数据转为一维张量
data = torch.tensor(encode(text), dtype=torch.long)

# 将数据分为训练集和验证集
n = int(0.9*len(data))
train_data = data[:n]
val_data = data[n:]


def get_batch(split):
    data = train_data if split == 'train' else val_data # 区分加载训练集还是验证集
    ix = torch.randint(len(data) - block_size,(batch_size,)) # 随机起点
    x = torch.stack([data[i:i+block_size] for i in ix])
    y = torch.stack([data[i+1:i+block_size+1] for i in ix])
    x,y = x.to(device), y.to(device)
    return x,y

@torch.no_grad()
def estimate_loss():
    out = {}
    model.eval()
    for split in ['train', 'val']:
        losses = torch.zeros(eval_iters)
        for k in range(eval_iters):
            X, Y = get_batch(split)
            logits, loss = model(X, Y)
            losses[k] = loss.item()
        out[split] = losses.mean()
    model.train()
    return out

class Head(nn.Module):
    def __init__(self, head_size):
        super().__init__()
        self.key = nn.Linear(n_embd, head_size, bias=False)
        self.query = nn.Linear(n_embd, head_size, bias=False)
        self.value = nn.Linear(n_embd, head_size, bias=False)
        self.register_buffer('tril', torch.tril(torch.ones(block_size, block_size)))

    def forward(self, x):
        B, T, C = x.shape
        k = self.key(x)
        q = self.query(x)

        wei = q @ k.transpose(-2, -1) * k.shape[-1]**-0.5
        wei = wei.masked_fill(self.tril[:T, :T] == 0, float('-inf'))
        wei = F.softmax(wei, dim=-1)

        v = self.value(x)
        out = wei @ v
        return out

class BigramLanguageModel(nn.Module):

    def __init__(self):
        super().__init__()
        self.token_embedding_table = nn.Embedding(vocab_size, n_embd) # (65, 32)
        self.position_embedding_table = nn.Embedding(block_size, n_embd) # (8, 32)
        self.lm_head = nn.Linear(n_embd, vocab_size)
        self.sa_head = Head(n_embd)

    def forward(self, idx, targets=None):
        B, T = idx.shape # B=4、T=8
        tok_emb = self.token_embedding_table(idx) # (4, 8, 32)
        pos_emb = self.position_embedding_table(torch.arange(T, device=device)) # (8, 32)
        x = tok_emb + pos_emb # (4, 8, 32) + (8, 32)  ->  (4, 8, 32) + (1, 8, 32) -> (4, 8, 32)
        x = self.sa_head(x)
        logits = self.lm_head(x) # (4, 8, 32) → (4, 8, 65)

        if targets is None:
            loss = None
        else:
            B, T, C = logits.shape
            logits = logits.view(B * T, C)
            targets = targets.view(B * T)
            loss = F.cross_entropy(logits, targets)

        return logits, loss

    def generate(self, idx, max_new_token):
        for _ in range(max_new_token):
            idx_cond = idx[:, -block_size:]
            logits , loss = self.forward(idx_cond)
            logits = logits[:, -1, :]
            probs = F.softmax(logits, dim=-1)
            idx_next = torch.multinomial(probs, num_samples=1)
            idx = torch.cat((idx, idx_next), dim = 1)
        return idx

model = BigramLanguageModel()
m = model.to(device)

optimizer = torch.optim.Adam(m.parameters(), lr=learning_rate)

for steps in range(max_iters):
    if steps % eval_interval == 0:
        losses = estimate_loss()
        print(f"step {steps}: train loss {losses['train']:.4f}, val loss {losses['val']:.4f}")
    xb, yb = get_batch('train')

    logits ,loss = m(xb, yb)
    optimizer.zero_grad(set_to_none=True)
    loss.backward()
    optimizer.step()

xb, yb = get_batch('train')
logits ,loss = m(xb, yb)
print('loss: ', loss.item())
idx = torch.zeros((1, 1), dtype=torch.long, device=device)
code = m.generate(idx, max_new_token=100)
print(decode(code[0].tolist()))
运行一下:
step 0: train loss 4.2468, val loss 4.2452
step 300: train loss 2.9372, val loss 2.9573
step 600: train loss 2.6529, val loss 2.6701
step 900: train loss 2.5592, val loss 2.5667
step 1200: train loss 2.5202, val loss 2.5194
step 1500: train loss 2.4848, val loss 2.4950
step 1800: train loss 2.4650, val loss 2.4743
step 2100: train loss 2.4496, val loss 2.4532
step 2400: train loss 2.4354, val loss 2.4550
step 2700: train loss 2.4209, val loss 2.4457
step 3000: train loss 2.4331, val loss 2.4332
step 3300: train loss 2.4236, val loss 2.4326
step 3600: train loss 2.4129, val loss 2.4277
step 3900: train loss 2.4096, val loss 2.4269
step 4200: train loss 2.4024, val loss 2.4369
step 4500: train loss 2.3964, val loss 2.4086
step 4800: train loss 2.3891, val loss 2.4090
loss:  2.2492098808288574

Whent aknt,
TI'wilen is s, ble

Hiset bobe ton.
Sthr-'ts mealitanss:
Want he uw hat vet?
F dilas ate
可以看到,加入了自注意力头之后,我们的损失值终于降到了2.4以下,说明我们的工作是有效果的,但是效果还不是很好,所以我们可以将这一层自注意力头拆分成4个注意力头,每一个注意力头是8维的,这样可以从更多的维度学习特征,可以达到更好的效果:
class MultiHeadAttention(nn.Module):

    def __init__(self, num_heads, head_size):
        super().__init__()
        self.head = nn.ModuleList([Head(head_size) for _ in range(num_heads)])

    def forward(self, x):
        return torch.cat([h(x) for h in self.head], dim=-1)
以下是完整代码:
import torch
import torch.nn as nn
from torch.nn import functional as F
torch.manual_seed(1337)

batch_size = 32 # 批次大小
block_size = 8 # 块大小
max_iters = 5000
eval_interval = 300
learning_rate = 1e-3
device = 'cuda' if torch.cuda.is_available() else 'cpu'
eval_iters = 200
n_embd = 32
num_head = 4
head_size = n_embd // num_head

with open('input.txt', 'r', encoding='utf-8') as f:
    text = f.read()
chars = sorted(list(set(text)))
vocab_size = len(chars)

stoi = { ch:i for i,ch in enumerate(chars) }
itos = {i:ch for i,ch in enumerate(chars)}
encode = lambda s: [stoi[c] for c in s]
decode = lambda l: ''.join([itos[i] for i in l])


# 将数据转为一维张量
data = torch.tensor(encode(text), dtype=torch.long)

# 将数据分为训练集和验证集
n = int(0.9*len(data))
train_data = data[:n]
val_data = data[n:]


def get_batch(split):
    data = train_data if split == 'train' else val_data # 区分加载训练集还是验证集
    ix = torch.randint(len(data) - block_size,(batch_size,)) # 随机起点
    x = torch.stack([data[i:i+block_size] for i in ix])
    y = torch.stack([data[i+1:i+block_size+1] for i in ix])
    x,y = x.to(device), y.to(device)
    return x,y

@torch.no_grad()
def estimate_loss():
    out = {}
    model.eval()
    for split in ['train', 'val']:
        losses = torch.zeros(eval_iters)
        for k in range(eval_iters):
            X, Y = get_batch(split)
            logits, loss = model(X, Y)
            losses[k] = loss.item()
        out[split] = losses.mean()
    model.train()
    return out

class Head(nn.Module):
    def __init__(self, head_size):
        super().__init__()
        self.key = nn.Linear(n_embd, head_size, bias=False)
        self.query = nn.Linear(n_embd, head_size, bias=False)
        self.value = nn.Linear(n_embd, head_size, bias=False)
        self.register_buffer('tril', torch.tril(torch.ones(block_size, block_size)))

    def forward(self, x):
        B, T, C = x.shape
        k = self.key(x)
        q = self.query(x)

        wei = q @ k.transpose(-2, -1) * k.shape[-1]**-0.5
        wei = wei.masked_fill(self.tril[:T, :T] == 0, float('-inf'))
        wei = F.softmax(wei, dim=-1)

        v = self.value(x)
        out = wei @ v
        return out

class MultiHeadAttention(nn.Module):

    def __init__(self, num_heads, head_size):
        super().__init__()
        self.head = nn.ModuleList([Head(head_size) for _ in range(num_heads)])

    def forward(self, x):
        return torch.cat([h(x) for h in self.head], dim=-1)

class BigramLanguageModel(nn.Module):

    def __init__(self):
        super().__init__()
        self.token_embedding_table = nn.Embedding(vocab_size, n_embd) # (65, 32)
        self.position_embedding_table = nn.Embedding(block_size, n_embd) # (8, 32)
        self.lm_head = nn.Linear(n_embd, vocab_size)
        self.sa_head = MultiHeadAttention(num_head, head_size)

    def forward(self, idx, targets=None):
        B, T = idx.shape # B=4、T=8
        tok_emb = self.token_embedding_table(idx) # (4, 8, 32)
        pos_emb = self.position_embedding_table(torch.arange(T, device=device)) # (8, 32)
        x = tok_emb + pos_emb # (4, 8, 32) + (8, 32)  ->  (4, 8, 32) + (1, 8, 32) -> (4, 8, 32)
        x = self.sa_head(x)
        logits = self.lm_head(x) # (4, 8, 32) → (4, 8, 65)

        if targets is None:
            loss = None
        else:
            B, T, C = logits.shape
            logits = logits.view(B * T, C)
            targets = targets.view(B * T)
            loss = F.cross_entropy(logits, targets)

        return logits, loss

    def generate(self, idx, max_new_token):
        for _ in range(max_new_token):
            idx_cond = idx[:, -block_size:]
            logits , loss = self.forward(idx_cond)
            logits = logits[:, -1, :]
            probs = F.softmax(logits, dim=-1)
            idx_next = torch.multinomial(probs, num_samples=1)
            idx = torch.cat((idx, idx_next), dim = 1)
        return idx

model = BigramLanguageModel()
m = model.to(device)

optimizer = torch.optim.Adam(m.parameters(), lr=learning_rate)

for steps in range(max_iters):
    if steps % eval_interval == 0:
        losses = estimate_loss()
        print(f"step {steps}: train loss {losses['train']:.4f}, val loss {losses['val']:.4f}")
    xb, yb = get_batch('train')

    logits ,loss = m(xb, yb)
    optimizer.zero_grad(set_to_none=True)
    loss.backward()
    optimizer.step()

xb, yb = get_batch('train')
logits ,loss = m(xb, yb)
print('loss: ', loss.item())
idx = torch.zeros((1, 1), dtype=torch.long, device=device)
code = m.generate(idx, max_new_token=100)
print(decode(code[0].tolist()))
运行一下:
step 0: train loss 4.2439, val loss 4.2423
step 300: train loss 2.8098, val loss 2.8238
step 600: train loss 2.5846, val loss 2.6018
step 900: train loss 2.4978, val loss 2.4958
step 1200: train loss 2.4529, val loss 2.4427
step 1500: train loss 2.4035, val loss 2.4074
step 1800: train loss 2.3731, val loss 2.3826
step 2100: train loss 2.3495, val loss 2.3508
step 2400: train loss 2.3237, val loss 2.3410
step 2700: train loss 2.3079, val loss 2.3311
step 3000: train loss 2.3054, val loss 2.3099
step 3300: train loss 2.2920, val loss 2.2993
step 3600: train loss 2.2737, val loss 2.2956
step 3900: train loss 2.2641, val loss 2.2892
step 4200: train loss 2.2528, val loss 2.2928
step 4500: train loss 2.2426, val loss 2.2681
step 4800: train loss 2.2305, val loss 2.2603
loss:  2.123969554901123

Whent ak tryocowd,
This thert madisen bobe toe.
Sagr-'t thealleands: rant he us crome.
War dilth ane
虽然效果还是不尽如人意,但是我们的损失值确实是在下降的。
增加前馈网络
现在的模型里,attention 捞回信息后立刻就送去预测了,中间没有任何加工环节。而分工应该是:
attention = 跨位置交流,把前文的信息搬过来
FFN = 每个位置自己消化,想想这些信息意味着什么
而且 attention 全是线性运算),没有非线性。而FFN 的 ReLU 是整个模型里真正的非线性来源。
class FeedForward(nn.Module):
    def __init__(self, n_embd):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(n_embd, n_embd),
            nn.ReLU(),
        )

    def forward(self, x):
        return self.net(x)
在BigramLanguageModel中加入FFN层:
class BigramLanguageModel(nn.Module):

    def __init__(self):
        super().__init__()
        self.token_embedding_table = nn.Embedding(vocab_size, n_embd) # (65, 32)
        self.position_embedding_table = nn.Embedding(block_size, n_embd) # (8, 32)
        self.lm_head = nn.Linear(n_embd, vocab_size)
        self.sa_head = MultiHeadAttention(num_head, head_size)
        self.ffwd = FeedForward(n_embd)

    def forward(self, idx, targets=None):
        B, T = idx.shape # B=4、T=8
        tok_emb = self.token_embedding_table(idx) # (4, 8, 32)
        pos_emb = self.position_embedding_table(torch.arange(T, device=device)) # (8, 32)
        x = tok_emb + pos_emb # (4, 8, 32) + (8, 32)  ->  (4, 8, 32) + (1, 8, 32) -> (4, 8, 32)
        x = self.sa_head(x)
        x = self.ffwd(x)
        logits = self.lm_head(x) # (4, 8, 32) → (4, 8, 65)

        if targets is None:
            loss = None
        else:
            B, T, C = logits.shape
            logits = logits.view(B * T, C)
            targets = targets.view(B * T)
            loss = F.cross_entropy(logits, targets)

        return logits, loss

    def generate(self, idx, max_new_token):
        for _ in range(max_new_token):
            idx_cond = idx[:, -block_size:]
            logits , loss = self.forward(idx_cond)
            logits = logits[:, -1, :]
            probs = F.softmax(logits, dim=-1)
            idx_next = torch.multinomial(probs, num_samples=1)
            idx = torch.cat((idx, idx_next), dim = 1)
        return idx
运行一下:
step 0: train loss 4.2038, val loss 4.2009
step 300: train loss 2.7736, val loss 2.7907
step 600: train loss 2.5722, val loss 2.5836
step 900: train loss 2.4995, val loss 2.4857
step 1200: train loss 2.4415, val loss 2.4370
step 1500: train loss 2.3883, val loss 2.3961
step 1800: train loss 2.3583, val loss 2.3628
step 2100: train loss 2.3327, val loss 2.3350
step 2400: train loss 2.3102, val loss 2.3277
step 2700: train loss 2.2879, val loss 2.3076
step 3000: train loss 2.2890, val loss 2.2863
step 3300: train loss 2.2730, val loss 2.2742
step 3600: train loss 2.2486, val loss 2.2684
step 3900: train loss 2.2425, val loss 2.2667
step 4200: train loss 2.2275, val loss 2.2657
step 4500: train loss 2.2147, val loss 2.2376
step 4800: train loss 2.2085, val loss 2.2217
loss:  2.2788593769073486


Yre bef bridcowilen is sow the airet bube don.
Shirnd my dagatauss:
Whith fou qor he.
War dils
Hate
实现多层堆叠
我们可以将自注意力层和前馈网络组成一个Block,再进行多层堆叠,来实现深度神经网络:
class Block(nn.Module):
    def __init__(self, n_embd, n_head):
        super().__init__()
        self.sa = MultiHeadAttention(n_head, n_embd // n_head)
        self.ffwd = FeedForward(n_embd)

    def forward(self, x):
        x = self.sa(x)
        x = self.ffwd(x)
        return x
残差连接
为了解决多层堆叠的深度神经网络随着层数变多,效果反而变差的问题,我们可以通过残差连接的方式,让梯度可以进行有效的传导:
class Block(nn.Module):
    def __init__(self, n_embd, n_head):
        super().__init__()
        self.sa = MultiHeadAttention(n_head, n_embd // n_head)
        self.ffwd = FeedForward(n_embd)

    def forward(self, x):
        x = x + self.sa(x)
        x = x + self.ffwd(x)
        return x
给多头注意力加一个投影层
在多头注意力层后面加一个投影层,可以将原本4个多头注意力得到的信息汇总成一个,让每一个位置都能享受到每一头注意力的训练效果:
class MultiHeadAttention(nn.Module):

    def __init__(self, num_heads, head_size):
        super().__init__()
        self.head = nn.ModuleList([Head(head_size) for _ in range(num_heads)])
        self.proj = nn.Linear(n_embd, n_embd)

    def forward(self, x):
        out = torch.cat([h(x) for h in self.head], dim=-1)
        out = self.proj(out)
        return out
把 FeedForward 改成宽版
在更宽的空间里,ReLU 能做出更精细的判断:
class FeedForward(nn.Module):
    def __init__(self, n_embd):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(n_embd, 4 * n_embd),
            nn.ReLU(),
            nn.Linear(4 * n_embd, n_embd),
        )

    def forward(self, x):
        return self.net(x)
给 Block 加归一化
给Block加入归一化LayerNorm 可以解决数值漂移:
class Block(nn.Module):
    def __init__(self, n_embd, n_head):
        super().__init__()
        self.sa = MultiHeadAttention(n_head, n_embd // n_head)
        self.ffwd = FeedForward(n_embd)
        self.ln1 = nn.LayerNorm(n_embd)
        self.ln2 = nn.LayerNorm(n_embd)

    def forward(self, x):
        x = x + self.sa(self.ln1(x))
        x = x + self.ffwd(self.ln2(x))
        return x
修改模型
现在我们开始组装模型,把Block加入进去,以下是完整代码:
import torch
import torch.nn as nn
from torch.nn import functional as F
torch.manual_seed(1337)

batch_size = 32 # 批次大小
block_size = 8 # 块大小
max_iters = 5000
eval_interval = 300
learning_rate = 1e-3
device = 'cuda' if torch.cuda.is_available() else 'cpu'
eval_iters = 200
n_embd = 32
num_head = 4
head_size = n_embd // num_head
n_layer = 3

with open('input.txt', 'r', encoding='utf-8') as f:
    text = f.read()
chars = sorted(list(set(text)))
vocab_size = len(chars)

stoi = { ch:i for i,ch in enumerate(chars) }
itos = {i:ch for i,ch in enumerate(chars)}
encode = lambda s: [stoi[c] for c in s]
decode = lambda l: ''.join([itos[i] for i in l])


# 将数据转为一维张量
data = torch.tensor(encode(text), dtype=torch.long)

# 将数据分为训练集和验证集
n = int(0.9*len(data))
train_data = data[:n]
val_data = data[n:]


def get_batch(split):
    data = train_data if split == 'train' else val_data # 区分加载训练集还是验证集
    ix = torch.randint(len(data) - block_size,(batch_size,)) # 随机起点
    x = torch.stack([data[i:i+block_size] for i in ix])
    y = torch.stack([data[i+1:i+block_size+1] for i in ix])
    x,y = x.to(device), y.to(device)
    return x,y

@torch.no_grad()
def estimate_loss():
    out = {}
    model.eval()
    for split in ['train', 'val']:
        losses = torch.zeros(eval_iters)
        for k in range(eval_iters):
            X, Y = get_batch(split)
            logits, loss = model(X, Y)
            losses[k] = loss.item()
        out[split] = losses.mean()
    model.train()
    return out

class Head(nn.Module):
    def __init__(self, head_size):
        super().__init__()
        self.key = nn.Linear(n_embd, head_size, bias=False)
        self.query = nn.Linear(n_embd, head_size, bias=False)
        self.value = nn.Linear(n_embd, head_size, bias=False)
        self.register_buffer('tril', torch.tril(torch.ones(block_size, block_size)))

    def forward(self, x):
        B, T, C = x.shape
        k = self.key(x)
        q = self.query(x)

        wei = q @ k.transpose(-2, -1) * k.shape[-1]**-0.5
        wei = wei.masked_fill(self.tril[:T, :T] == 0, float('-inf'))
        wei = F.softmax(wei, dim=-1)

        v = self.value(x)
        out = wei @ v
        return out

class MultiHeadAttention(nn.Module):

    def __init__(self, num_heads, head_size):
        super().__init__()
        self.head = nn.ModuleList([Head(head_size) for _ in range(num_heads)])
        self.proj = nn.Linear(n_embd, n_embd)

    def forward(self, x):
        out = torch.cat([h(x) for h in self.head], dim=-1)
        out = self.proj(out)
        return out

class FeedForward(nn.Module):
    def __init__(self, n_embd):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(n_embd, 4 * n_embd),
            nn.ReLU(),
            nn.Linear(4 * n_embd, n_embd),
        )

    def forward(self, x):
        return self.net(x)

class Block(nn.Module):
    def __init__(self, n_embd, n_head):
        super().__init__()
        self.sa = MultiHeadAttention(n_head, n_embd // n_head)
        self.ffwd = FeedForward(n_embd)
        self.ln1 = nn.LayerNorm(n_embd)
        self.ln2 = nn.LayerNorm(n_embd)

    def forward(self, x):
        x = x + self.sa(self.ln1(x))
        x = x + self.ffwd(self.ln2(x))
        return x

class BigramLanguageModel(nn.Module):

    def __init__(self):
        super().__init__()
        self.token_embedding_table = nn.Embedding(vocab_size, n_embd) # (65, 32)
        self.position_embedding_table = nn.Embedding(block_size, n_embd) # (8, 32)
        self.lm_head = nn.Linear(n_embd, vocab_size)
        self.blocks = nn.Sequential(*[Block(n_embd, num_head) for _ in range(n_layer)])
        self.ln_f = nn.LayerNorm(n_embd)

    def forward(self, idx, targets=None):
        B, T = idx.shape # B=4、T=8
        tok_emb = self.token_embedding_table(idx) # (4, 8, 32)
        pos_emb = self.position_embedding_table(torch.arange(T, device=device)) # (8, 32)
        x = tok_emb + pos_emb # (4, 8, 32) + (8, 32)  ->  (4, 8, 32) + (1, 8, 32) -> (4, 8, 32)
        x = self.blocks(x)
        x = self.ln_f(x)
        logits = self.lm_head(x) # (4, 8, 32) → (4, 8, 65)

        if targets is None:
            loss = None
        else:
            B, T, C = logits.shape
            logits = logits.view(B * T, C)
            targets = targets.view(B * T)
            loss = F.cross_entropy(logits, targets)

        return logits, loss

    def generate(self, idx, max_new_token):
        for _ in range(max_new_token):
            idx_cond = idx[:, -block_size:]
            logits , loss = self.forward(idx_cond)
            logits = logits[:, -1, :]
            probs = F.softmax(logits, dim=-1)
            idx_next = torch.multinomial(probs, num_samples=1)
            idx = torch.cat((idx, idx_next), dim = 1)
        return idx

model = BigramLanguageModel()
m = model.to(device)

optimizer = torch.optim.Adam(m.parameters(), lr=learning_rate)

for steps in range(max_iters):
    if steps % eval_interval == 0:
        losses = estimate_loss()
        print(f"step {steps}: train loss {losses['train']:.4f}, val loss {losses['val']:.4f}")
    xb, yb = get_batch('train')

    logits ,loss = m(xb, yb)
    optimizer.zero_grad(set_to_none=True)
    loss.backward()
    optimizer.step()

xb, yb = get_batch('train')
logits ,loss = m(xb, yb)
print('loss: ', loss.item())
idx = torch.zeros((1, 1), dtype=torch.long, device=device)
code = m.generate(idx, max_new_token=100)
print(decode(code[0].tolist()))
运行一下:
step 0: train loss 4.3026, val loss 4.2987
step 300: train loss 2.5105, val loss 2.5183
step 600: train loss 2.3595, val loss 2.3622
step 900: train loss 2.2617, val loss 2.2782
step 1200: train loss 2.1920, val loss 2.2222
step 1500: train loss 2.1568, val loss 2.1908
step 1800: train loss 2.1267, val loss 2.1737
step 2100: train loss 2.0928, val loss 2.1419
step 2400: train loss 2.0855, val loss 2.1328
step 2700: train loss 2.0757, val loss 2.1268
step 3000: train loss 2.0499, val loss 2.0906
step 3300: train loss 2.0264, val loss 2.0967
step 3600: train loss 2.0195, val loss 2.0893
step 3900: train loss 2.0213, val loss 2.0897
step 4200: train loss 2.0038, val loss 2.0701
step 4500: train loss 1.9887, val loss 2.0669
step 4800: train loss 1.9666, val loss 2.0668
loss:  1.8026065826416016


YCORK:
Sery cowe,
The lay be madishombear toe.
Stirn' my day, and barththile were, to bar dilthoate
堆叠成功了,有明显效果!
添加 Dropout
Dropout会将一部分神经元关闭,我们接下来要极大地扩展模型。在这种情况下,Dropout对防止过拟合的发生有一定帮助:
import torch
import torch.nn as nn
from torch.nn import functional as F
torch.manual_seed(1337)

batch_size = 32 # 批次大小
block_size = 8 # 块大小
max_iters = 5000
eval_interval = 300
learning_rate = 1e-3
device = 'cuda' if torch.cuda.is_available() else 'cpu'
eval_iters = 200
n_embd = 32
num_head = 4
head_size = n_embd // num_head
n_layer = 3
dropout = 0.2

with open('input.txt', 'r', encoding='utf-8') as f:
    text = f.read()
chars = sorted(list(set(text)))
vocab_size = len(chars)

stoi = { ch:i for i,ch in enumerate(chars) }
itos = {i:ch for i,ch in enumerate(chars)}
encode = lambda s: [stoi[c] for c in s]
decode = lambda l: ''.join([itos[i] for i in l])


# 将数据转为一维张量
data = torch.tensor(encode(text), dtype=torch.long)

# 将数据分为训练集和验证集
n = int(0.9*len(data))
train_data = data[:n]
val_data = data[n:]


def get_batch(split):
    data = train_data if split == 'train' else val_data # 区分加载训练集还是验证集
    ix = torch.randint(len(data) - block_size,(batch_size,)) # 随机起点
    x = torch.stack([data[i:i+block_size] for i in ix])
    y = torch.stack([data[i+1:i+block_size+1] for i in ix])
    x,y = x.to(device), y.to(device)
    return x,y

@torch.no_grad()
def estimate_loss():
    out = {}
    model.eval()
    for split in ['train', 'val']:
        losses = torch.zeros(eval_iters)
        for k in range(eval_iters):
            X, Y = get_batch(split)
            logits, loss = model(X, Y)
            losses[k] = loss.item()
        out[split] = losses.mean()
    model.train()
    return out

class Head(nn.Module):
    def __init__(self, head_size):
        super().__init__()
        self.key = nn.Linear(n_embd, head_size, bias=False)
        self.query = nn.Linear(n_embd, head_size, bias=False)
        self.value = nn.Linear(n_embd, head_size, bias=False)
        self.register_buffer('tril', torch.tril(torch.ones(block_size, block_size)))
        self.dropout = nn.Dropout(dropout)

    def forward(self, x):
        B, T, C = x.shape
        k = self.key(x)
        q = self.query(x)

        wei = q @ k.transpose(-2, -1) * k.shape[-1]**-0.5
        wei = wei.masked_fill(self.tril[:T, :T] == 0, float('-inf'))
        wei = F.softmax(wei, dim=-1)
        wei = self.dropout(wei)

        v = self.value(x)
        out = wei @ v
        return out

class MultiHeadAttention(nn.Module):

    def __init__(self, num_heads, head_size):
        super().__init__()
        self.head = nn.ModuleList([Head(head_size) for _ in range(num_heads)])
        self.proj = nn.Linear(n_embd, n_embd)
        self.dropout = nn.Dropout(dropout)

    def forward(self, x):
        out = torch.cat([h(x) for h in self.head], dim=-1)
        out = self.dropout(self.proj(out))
        return out

class FeedForward(nn.Module):
    def __init__(self, n_embd):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(n_embd, 4 * n_embd),
            nn.ReLU(),
            nn.Linear(4 * n_embd, n_embd),
            nn.Dropout(dropout),
        )

    def forward(self, x):
        return self.net(x)

class Block(nn.Module):
    def __init__(self, n_embd, n_head):
        super().__init__()
        self.sa = MultiHeadAttention(n_head, n_embd // n_head)
        self.ffwd = FeedForward(n_embd)
        self.ln1 = nn.LayerNorm(n_embd)
        self.ln2 = nn.LayerNorm(n_embd)

    def forward(self, x):
        x = x + self.sa(self.ln1(x))
        x = x + self.ffwd(self.ln2(x))
        return x

class BigramLanguageModel(nn.Module):

    def __init__(self):
        super().__init__()
        self.token_embedding_table = nn.Embedding(vocab_size, n_embd) # (65, 32)
        self.position_embedding_table = nn.Embedding(block_size, n_embd) # (8, 32)
        self.lm_head = nn.Linear(n_embd, vocab_size)
        self.blocks = nn.Sequential(*[Block(n_embd, num_head) for _ in range(n_layer)])
        self.ln_f = nn.LayerNorm(n_embd)

    def forward(self, idx, targets=None):
        B, T = idx.shape # B=4、T=8
        tok_emb = self.token_embedding_table(idx) # (4, 8, 32)
        pos_emb = self.position_embedding_table(torch.arange(T, device=device)) # (8, 32)
        x = tok_emb + pos_emb # (4, 8, 32) + (8, 32)  ->  (4, 8, 32) + (1, 8, 32) -> (4, 8, 32)
        x = self.blocks(x)
        x = self.ln_f(x)
        logits = self.lm_head(x) # (4, 8, 32) → (4, 8, 65)

        if targets is None:
            loss = None
        else:
            B, T, C = logits.shape
            logits = logits.view(B * T, C)
            targets = targets.view(B * T)
            loss = F.cross_entropy(logits, targets)

        return logits, loss

    def generate(self, idx, max_new_token):
        for _ in range(max_new_token):
            idx_cond = idx[:, -block_size:]
            logits , loss = self.forward(idx_cond)
            logits = logits[:, -1, :]
            probs = F.softmax(logits, dim=-1)
            idx_next = torch.multinomial(probs, num_samples=1)
            idx = torch.cat((idx, idx_next), dim = 1)
        return idx

model = BigramLanguageModel()
m = model.to(device)

optimizer = torch.optim.Adam(m.parameters(), lr=learning_rate)

for steps in range(max_iters):
    if steps % eval_interval == 0:
        losses = estimate_loss()
        print(f"step {steps}: train loss {losses['train']:.4f}, val loss {losses['val']:.4f}")
    xb, yb = get_batch('train')

    logits ,loss = m(xb, yb)
    optimizer.zero_grad(set_to_none=True)
    loss.backward()
    optimizer.step()

xb, yb = get_batch('train')
logits ,loss = m(xb, yb)
print('loss: ', loss.item())
idx = torch.zeros((1, 1), dtype=torch.long, device=device)
code = m.generate(idx, max_new_token=100)
print(decode(code[0].tolist()))
扩大模型
现在我们将模型进行大规模的放大,修改配置区:
batch_size = 64 # 批次大小
block_size = 256 # 块大小
max_iters = 5000
eval_interval = 500
learning_rate = 3e-4
device = 'cuda' if torch.cuda.is_available() else 'cpu'
eval_iters = 200
n_embd = 384
num_head = 6
head_size = n_embd // num_head
n_layer = 6
dropout = 0.2
运行一下:
step 0: train loss 4.2835, val loss 4.2872
step 500: train loss 1.8878, val loss 1.9991
step 1000: train loss 1.5391, val loss 1.7281
step 1500: train loss 1.3933, val loss 1.6026
step 2000: train loss 1.3073, val loss 1.5525
step 2500: train loss 1.2483, val loss 1.5242
step 3000: train loss 1.2022, val loss 1.5059
step 3500: train loss 1.1609, val loss 1.4910
step 4000: train loss 1.1213, val loss 1.4901
step 4500: train loss 1.0867, val loss 1.4871
loss:  1.1334030628204346

KING EDWARD IV:
What, grant, lord, will you just now,
Thus you repose the true of the king,
Thore no
可以看到,损失已经降到1.08了,验证集的损失也降到了1.4,说明我们的工作是非常富有成效的。
结语
这次,我们完整地实现了一次Transformer架构的神经网络,并且让其输出了莎士比亚风格的文本。从一开始的二元语言模型到结尾的Transformer架构模型,我们学到了很多。也对我们学习深度神经网络有极大的帮助。